같은 커피를 열 번 찍으면
커피 가루 사진 한 장의 답은 얼마나 믿을 만한가. 부트스트랩과 정답을 아는 모집단으로, 입자를 몇 개 세야 하는지 쟀다. ±5%에 닿으려면 개수 중앙값은 400개, 부피 중앙값은 3,000~4,000개, 부피 D90은 2만 개 넘게 필요했고, 같은 커피의 가짜 사진 30장을 합쳐도 측정의 치우침(+31%)은 그대로 남았다.
지난 글에서는 붙은 입자를 떼어 내는 여섯 가지 방법을 채점했다. 가녜의 예시 사진 한 장에 돌렸더니 방법에 따라 부피 중앙값이 710 µm부터 1,057 µm까지 갈렸다. 어느 방법이 맞는지와는 별개로 물어야 할 것이 하나 더 있다. 방법이 완벽하다고 쳐도, 사진 한 장의 답은 얼마나 믿을 만한가.
같은 봉지의 커피를 한 번 더 뿌려 찍으면 다른 입자들이 찍힌다. 그러면 답도 조금 달라진다. 이번 글은 그 차이가 얼마나 되는지, 그리고 그것을 줄이려면 입자를 몇 개나 세야 하는지 잰다.
사진 한 장은 표본이다
사진에 찍힌 입자는 그라인더에서 나온 가루 전체가 아니다. 한 꼬집 덜어 종이에 뿌린 것이고, 그중에서도 사진 틀 안에 든 것만 찍힌다. 통계에서 말하는 표본이다. 표본으로 모집단을 어림하면 두 가지 오차가 생긴다.
- 뽑기 오차: 어떤 입자가 우연히 표본에 들어왔느냐에 따라 생기는 오차. 표본이 클수록 줄어든다
- 재기 오차: 표본에 든 입자를 잘못 재서 생기는 오차. 8편과 9편에서 본 붙은 덩어리, 문턱의 치우침이 여기에 든다. 표본을 키워도 줄지 않는다
이 글은 앞의 것을 주로 다루고, 마지막에 두 오차를 함께 놓아 본다.
부피로 세면 입자가 줄어든다
6편에서 같은 커피도 개수로 세느냐 부피로 세느냐에 따라 다른 그래프가 된다는 것을 봤다. 이 글에서 쓰는 가녜 사진의 입자 1,561개(볼록도 0.85 미만 덩어리를 버린 것)는 개수 중앙값이 572 µm, 부피 중앙값이 878 µm다. 이 차이가 뽑기 오차에도 그대로 이어진다.
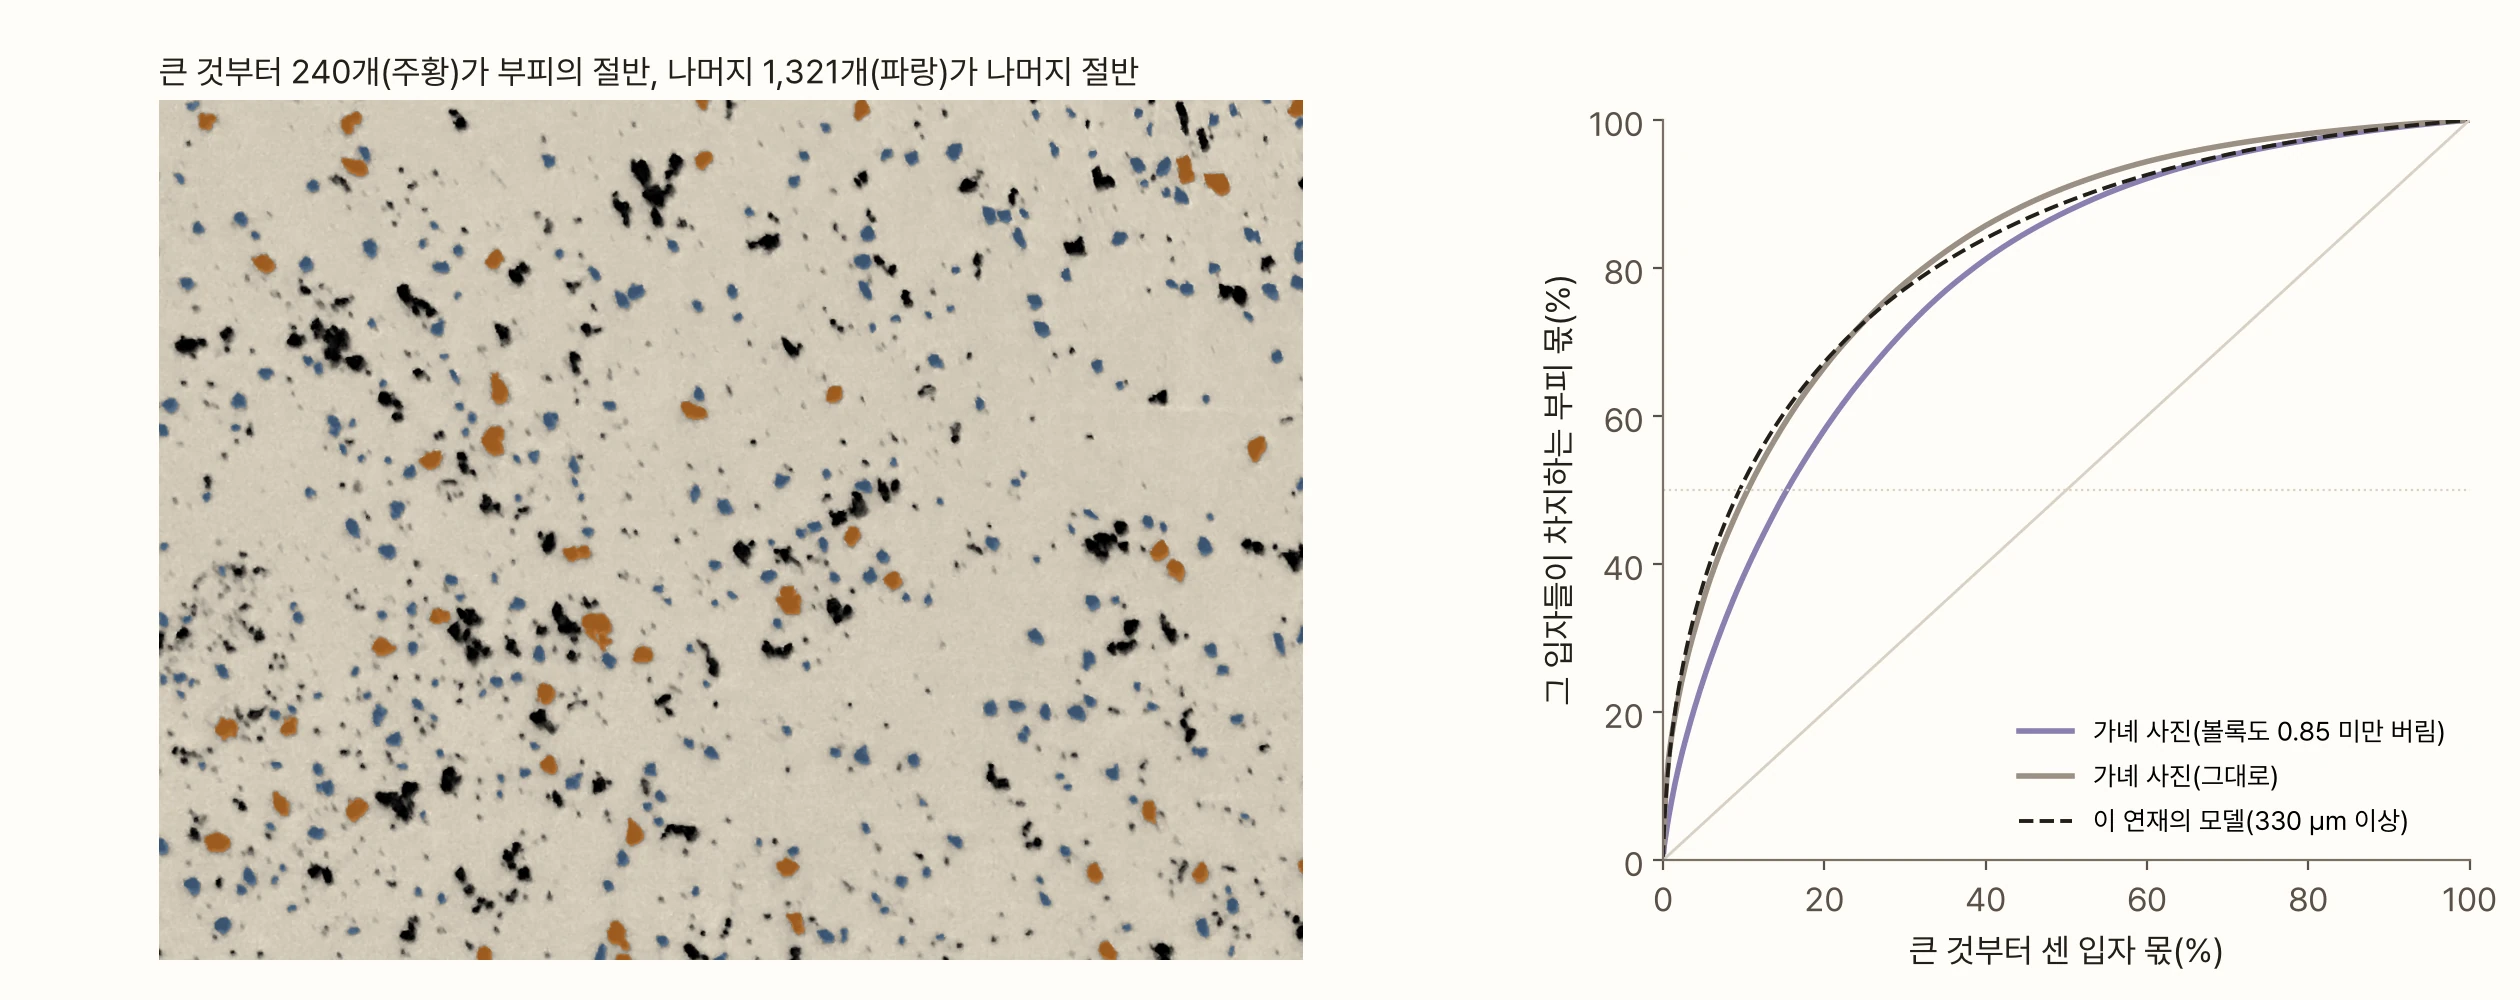
이 1,561개 가운데 큰 것부터 240개가 부피의 절반을 차지했다. 입자 수로는 15%다. 부피 중앙값은 사실상 이 240개가 정한다. 가장 큰 입자 하나가 전체 부피의 1.2%를 차지했다.
조사 통계에는 이런 상황을 재는 잣대가 있다. 키시(Kish)의 유효 표본 수로, 가중치의 합을 제곱해 가중치 제곱의 합으로 나눈다. 모든 입자의 가중치가 같으면 센 입자 수와 같고, 몇몇 입자가 가중치를 독차지할수록 작아진다. 부피를 가중치로 넣으면 1,561개의 유효 표본 수는 610개였다. 붙은 덩어리까지 그대로 센 경우(2,123개)는 388개로, 센 것의 18%만 센 셈이다. 큰 덩어리가 부피를 더 많이 차지하기 때문이다.
한 장으로 흩어짐을 재는 법
같은 커피를 여러 번 찍지 않고도 뽑기 오차를 어림하는 방법이 있다. 에프런이 1979년에 내놓은 부트스트랩이다. 사진에서 잰 입자 1,561개를 주머니에 넣고, 하나 꺼내 적고 다시 넣기를 1,561번 되풀이해 새 표본을 만든다. 어떤 입자는 두세 번 뽑히고 어떤 입자는 한 번도 안 뽑힌다. 이렇게 만든 표본마다 중앙값을 계산하면, 사진 한 장의 값이 뽑기 운에 따라 얼마나 흔들릴 수 있는지가 분포로 나온다. 그 분포의 가운데 95%를 95% 구간으로 쓴다.
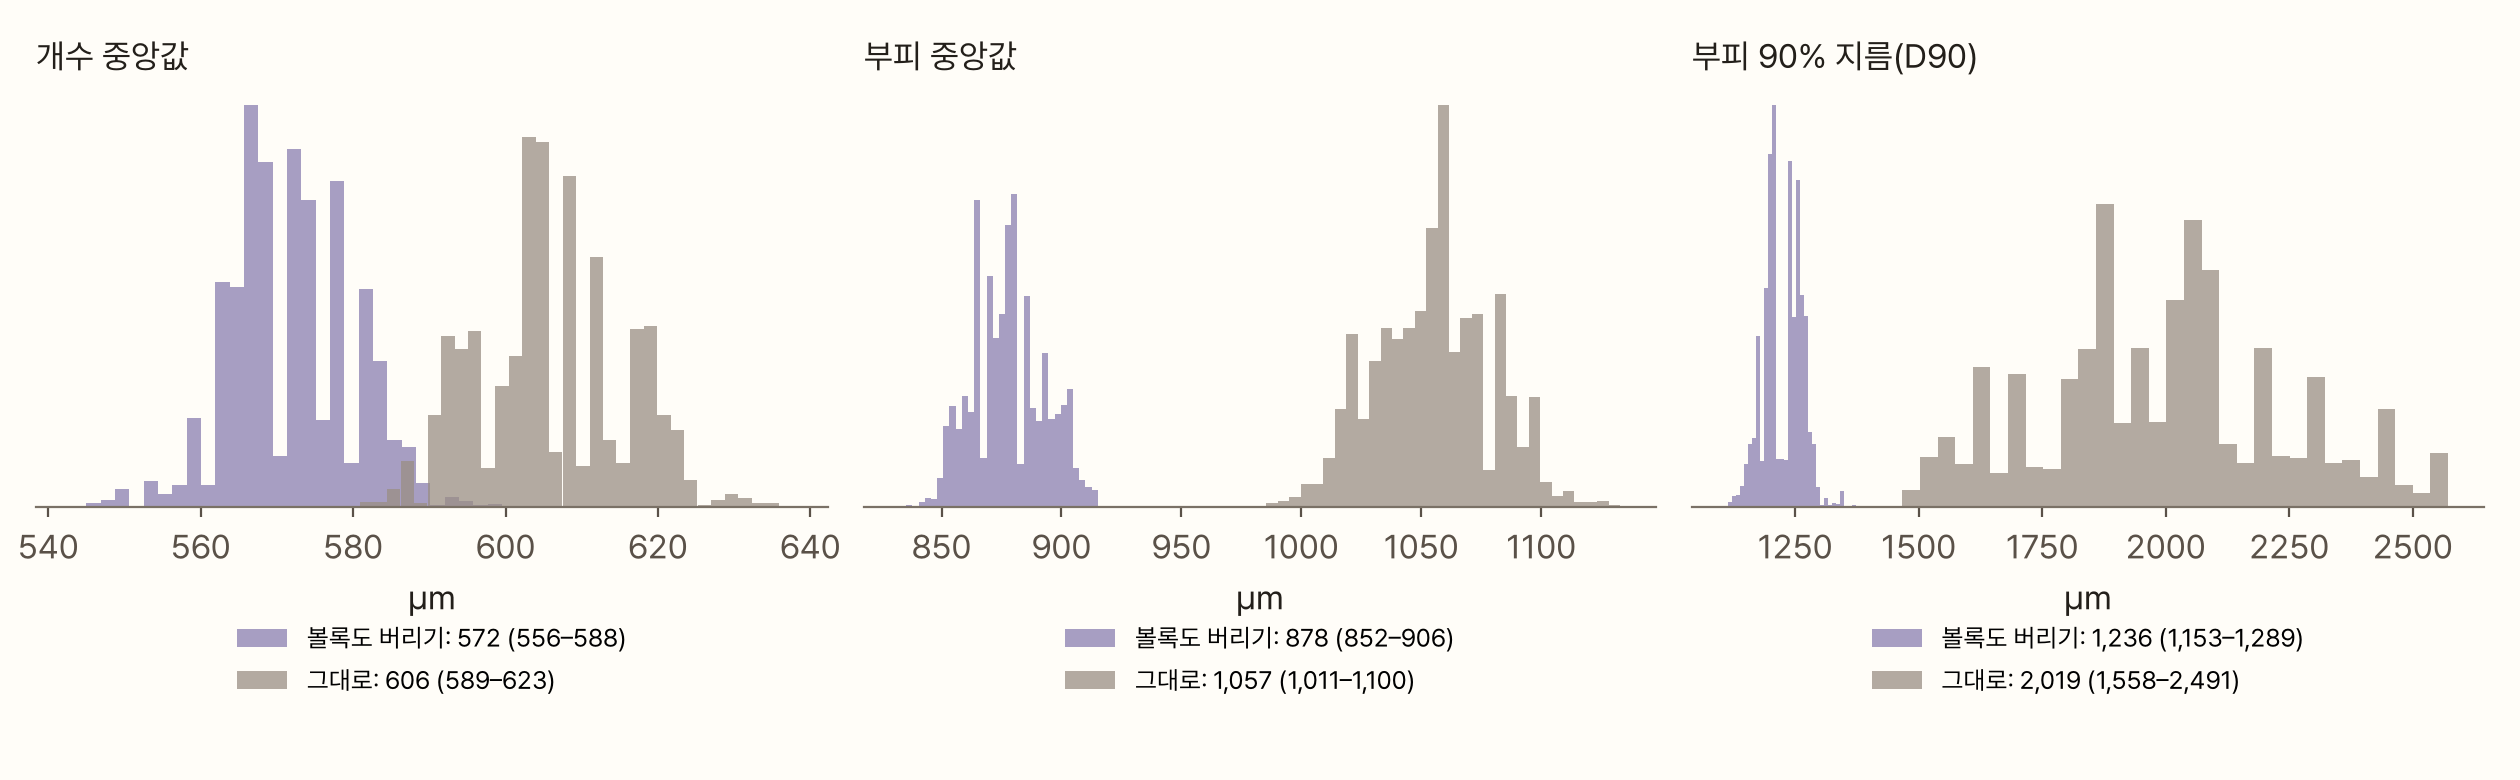
볼록도로 덩어리를 버린 경우 개수 중앙값, 부피 중앙값 모두 95% 구간이 ±3% 안팎이었다. 부피 90% 지름(D90, 부피의 90%가 이보다 작은 입자에 든다는 지름)은 ±5%였다. 덩어리를 그대로 두면 사정이 다르다. 부피 중앙값이 ±4%로 조금 넓어지고, D90은 1,558~2,491 µm로 거의 1 mm 폭에서 흔들린다. 분포의 꼬리를 큰 덩어리 몇 개가 쥐고 있기 때문이다. 큰 것부터 열 개만 빼도 부피 중앙값이 1,057 µm에서 1,000 µm로 5% 내려갔다.
여기서 하나 짚어 둘 것이 있다. coffeegrindsize가 그리는 그래프에도 막대가 붙어 있지만 뜻이 다르다. 코드를 보면 히스토그램 칸마다 그 칸에 든 입자 수의 제곱근에 칸의 평균 가중치를 곱해 푸아송 오차 막대를 단다. 평균 지름 점에 붙은 가로 막대는 불확도가 아니라 분포의 폭이다. 가녜는 블로그에서 이 막대가 "분포의 약 68%를 덮는 너비"라고 설명했다. 평균이 얼마나 정확한지는 따로 알려 주지 않는다. 가녜 자신도 이 점을 알았다. 2019년 블로그 댓글에서 작은 수의 통계가 "이 소프트웨어의 첫째 한계"라고 적었고, 글에 싣는 그래프는 "더 나은 통계를 얻으려고" 시료 12개를 찍은 사진 12장을 합쳐 만든다고 했다.
몇 개를 세야 하나
부트스트랩은 사진 한 장의 흩어짐을 어림하는 도구다. 그 어림이 맞는지 보려면 정답을 아는 모집단이 필요하다. 6편에서 만든 이 연재의 분쇄 모델을 썼다. 부피 기준으로 미분 봉우리와 굵은 봉우리를 섞은 분포에서 330 µm 이상 입자를 n개씩 뽑아 중앙값을 내고, 이것을 1,000번 되풀이해 값이 흩어지는 폭을 쟀다. 측정 오차는 하나도 없이 뽑기 운만 있는 실험이다. 이 모집단의 정답은 개수 중앙값 555 µm, 부피 중앙값 974 µm, 부피 D90 1,778 µm다.
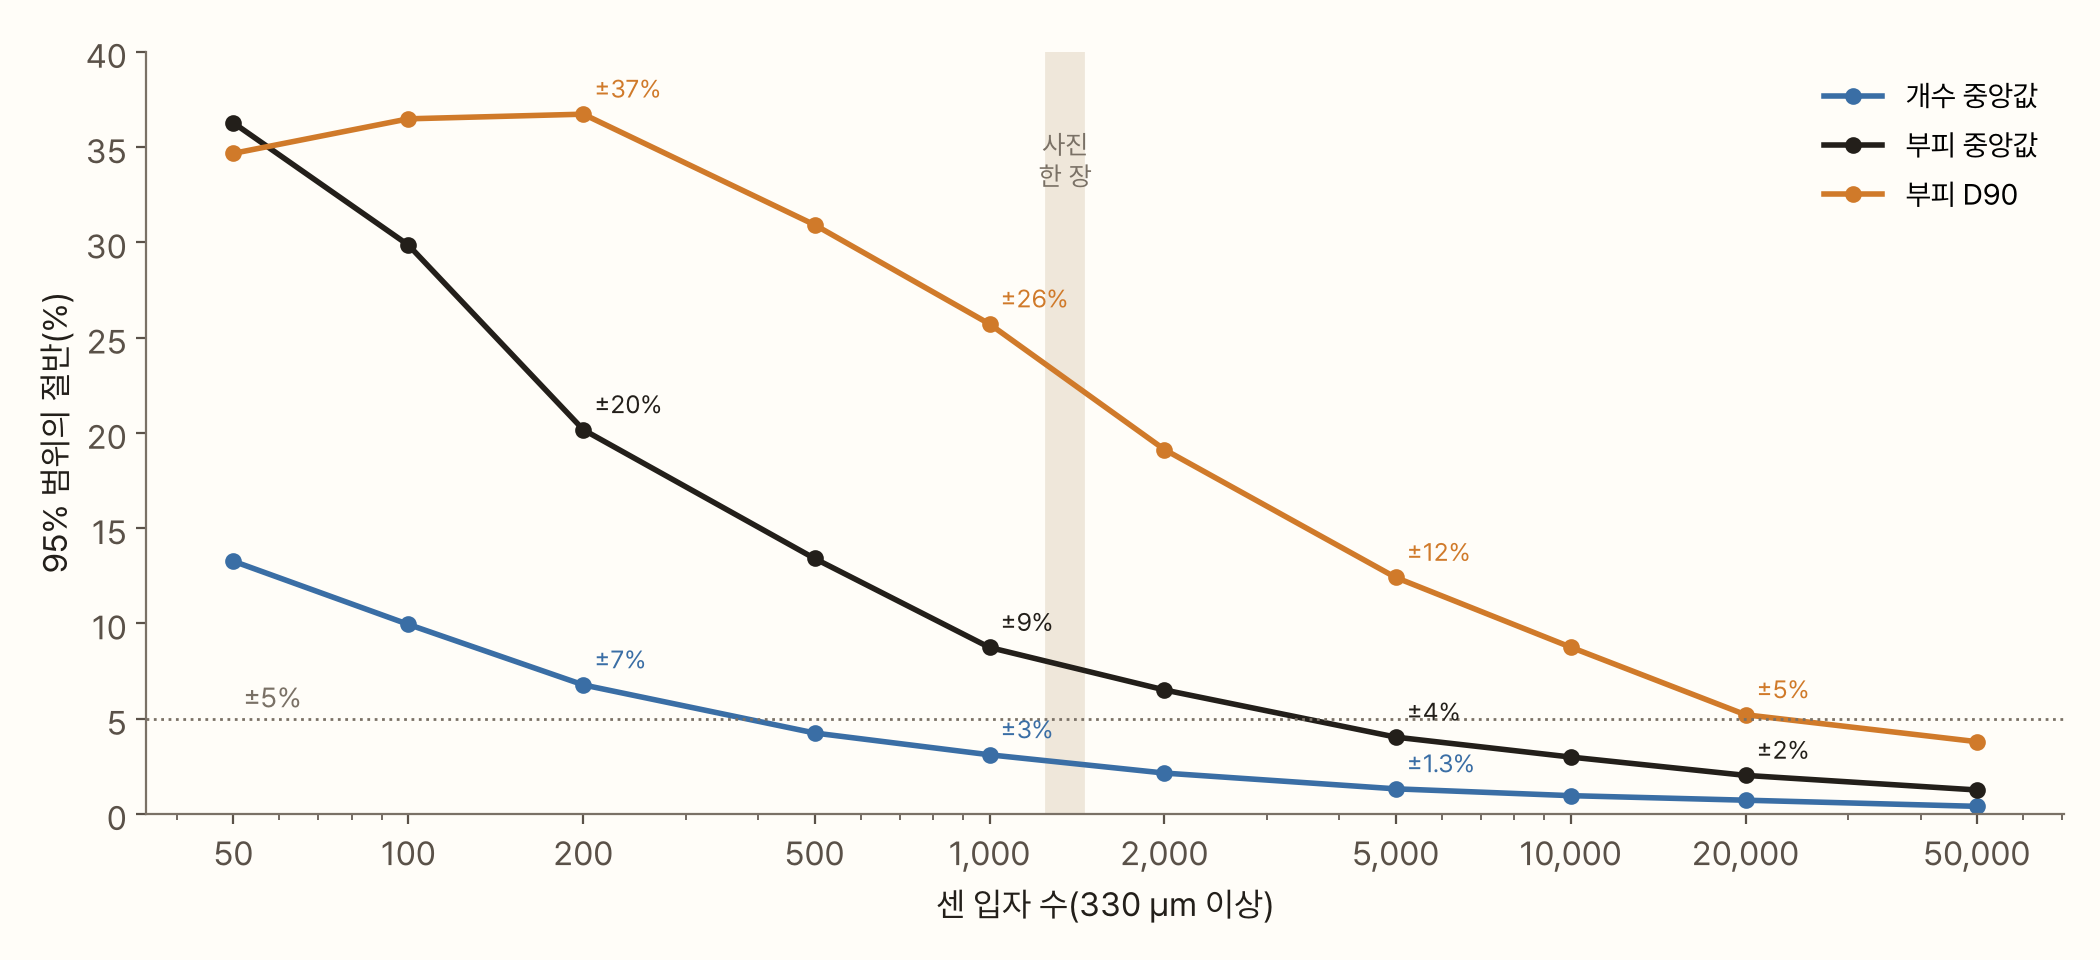
세 값이 같은 폭에 닿으려면 세어야 할 입자 수가 크게 다르다. ±5%(95% 범위의 절반)에 닿는 데 개수 중앙값은 400개쯤이면 되는데, 부피 중앙값은 3,000~4,000개, 부피 D90은 20,000개 넘게 필요했다. 셋 다 대체로 입자 수의 제곱근에 반비례해 줄어든다. 폭을 절반으로 줄이려면 네 배를 세야 한다.
가녜 사진처럼 한 장에 1,400개쯤 찍힌다면, 이 모델에서 사진 한 장의 부피 중앙값은 ±7~8%, D90은 ±20% 넘게 흔들린다. 앞에서 가녜 사진의 부트스트랩 구간(±3%)이 이보다 좁았던 것은 분포가 달라서다. 볼록도로 큰 덩어리를 버린 분포는 꼬리가 짧아서 유효 표본 수가 39%였는데, 이 모델은 2 mm 넘는 입자까지 있어서 17%다. 꼬리가 길수록 같은 개수로 얻는 정보가 적다.
정지 화상 입도 분석 표준 ISO 13322-1은 이 점을 첫머리에 적어 둔다. "분포의 종류(개수 기준이냐 부피 기준이냐)와 입도 분포의 폭은, 정해진 신뢰 한계 안에서 원하는 정확도를 얻으려면 몇 개의 입자를 재야 하는지에 아주 큰 영향을 준다." 이 표준의 부록에는 마스다와 고토(1999)의 계산으로 만든 표가 있다고 한다. 부록 원문은 확인하지 못했고, 호리바와 엔테그리스의 기술 자료에 옮겨 실린 표를 봤다. 로그정규 분포의 기하 표준편차가 1.6일 때 ±5%(95% 신뢰)를 얻는 데 필요한 입자 수가, 어떤 평균 지름이냐에 따라 6,092개에서 60,811개까지다. 업계에서 흔히 말하는 '6만 개'가 여기서 나왔다.
같은 폭의 로그정규 분포에서 부피 중앙값을 직접 뽑아 보니, 6,092개면 ±4%, 60,811개면 ±1.2%였다. 표의 가장 작은 숫자(6,092개)와 대체로 맞는다. 호리바의 바디콤(2013)도 실무 경험으로는 "ISO는 지나치게 보수적"이라고 했다. 다만 어느 쪽이든 순서는 같다. 개수로 셀 때는 수백 개, 부피로 셀 때는 수천 개, 분포의 꼬리를 보려면 수만 개다.
강바닥 자갈의 크기를 재는 지형학에서도 같은 결론이 나왔다. 이턴 등(2019)은 관례대로 자갈 100개를 재면 분위값의 불확도가 ±15~30%이고, 500개를 재도 ±9~18%라고 보고했다.
부트스트랩 구간은 믿을 만한가
같은 모집단에서 표본 하나를 뽑아 부트스트랩 95% 구간을 내고, 그 구간이 정답(974 µm)을 덮는지 300번 확인했다. 이름대로라면 95%가 덮어야 한다. 실제로는 입자 100개일 때 87%, 1,000개일 때 90%, 3,000개일 때 93%였다. 부피 중앙값처럼 큰 입자 몇 개가 쥐고 있는 값에서는 표본이 작을수록 부트스트랩 구간이 실제보다 좁게 나온다. 표본에 아예 안 들어온 큰 입자는 다시 뽑아도 나오지 않기 때문이다. 입자가 수천 개면 이 차이가 거의 사라진다.
한 장을 열두 칸으로 나누면
부트스트랩에는 전제가 하나 있다. 입자들이 서로 상관없이 뽑혔다는 것이다. 가루를 뿌릴 때 큰 입자는 굴러서 가장자리로 가고 미분은 한데 모인다면, 사진 안의 입자는 독립이 아니다. ISO 13322-1도 측정 영역 전체를 살펴서 크기에 따라 갈라진 데가 없는지 확인하라고 한다.
가녜 사진으로 확인해 봤다. 사진을 4 × 3, 열두 칸으로 나눠 칸마다 부피 중앙값을 냈다. 칸 하나에는 입자가 130개쯤 든다. 그리고 사진 전체의 입자 1,561개에서 아무렇게나 130개씩 뽑아 같은 계산을 4,000번 했다.
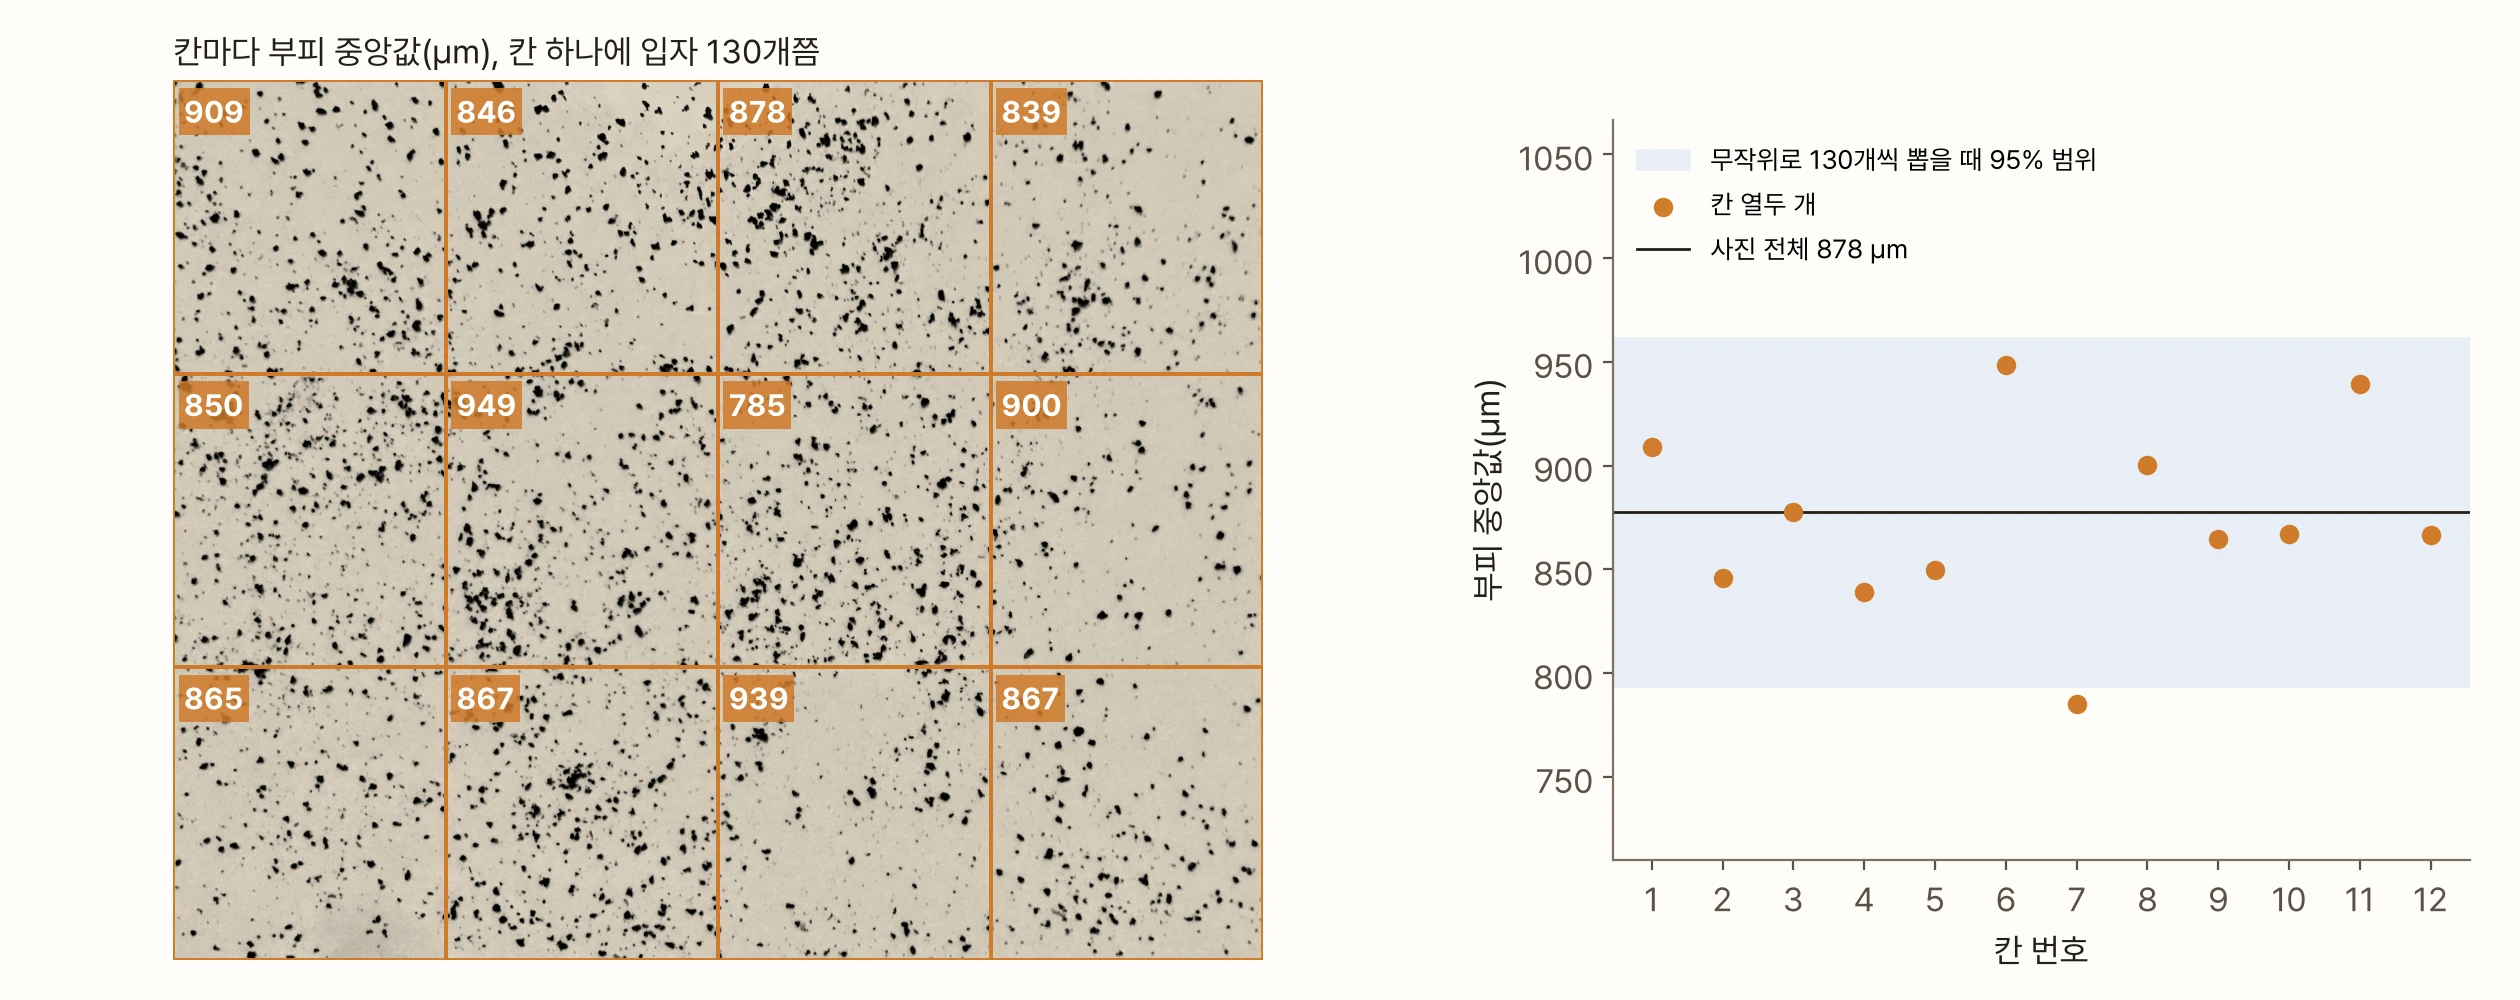
칸끼리의 흩어짐(표준편차 45 µm)은 무작위로 뽑았을 때(42 µm)와 거의 같았다. 열두 칸 가운데 열한 칸이 무작위 뽑기의 95% 범위 안에 들었다. 개수 중앙값도 24 µm 대 28 µm로 비슷했다. 적어도 이 사진에서는, 뿌린 가루가 크기에 따라 자리를 갈라 앉지 않았다. 사진 안의 입자를 무작위 표본으로 보고 부트스트랩을 써도 된다는 뜻이다.
이것은 한 꼬집 안의 이야기다. 봉지에서 꼬집을 덜어 내는 단계에서 크기가 갈렸는지는 이 사진으로 알 수 없다. 이 이야기는 뒤에서 다시 한다.
같은 커피를 서른 번 찍으면
진짜 커피로 같은 사진을 서른 번 찍을 수는 없었으니 가짜로 했다. 8편의 생성기로, 진짜를 닮은 설정 그대로 씨앗만 바꿔 가짜 사진 30장을 만들었다. 같은 봉지에서 매번 새로 덜어 뿌린 셈이다. 사진마다 330 µm 이상 정답 입자가 1,300~1,400개 찍혔다.
사진마다 세 가지 방법(그대로, 거리 분수령, 볼록도 0.85 미만 버리기)으로 재고, 측정한 덩어리로 부트스트랩 구간을 냈다. 그 사진에 실제로 뿌려진 정답 입자의 값도 함께 냈다. 이것은 재기 오차가 없을 때의 값이다.
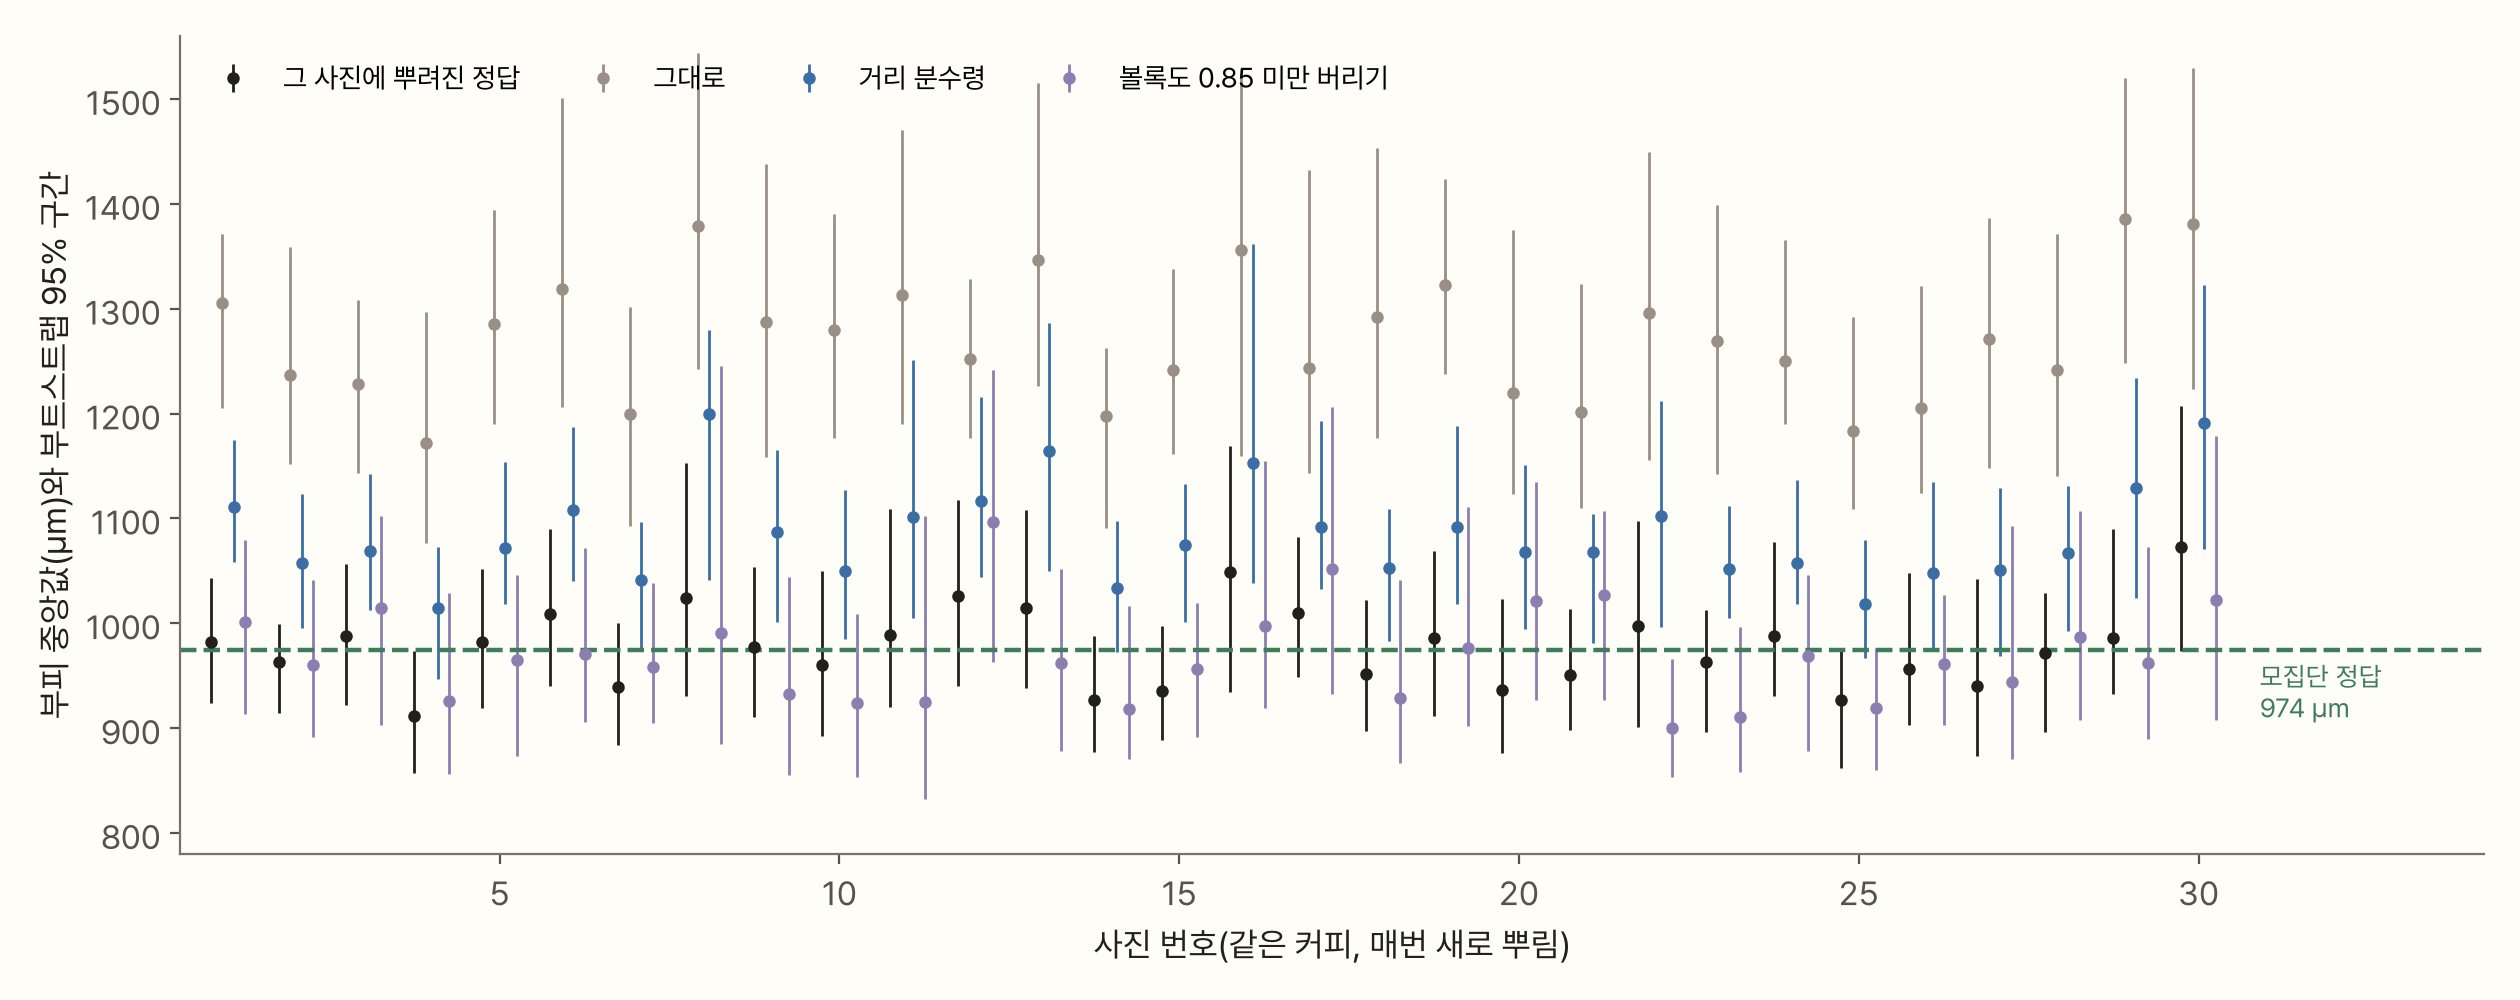
정답 입자만 놓고 보면 사진마다 부피 중앙값이 평균의 ±3.9%(표준편차)만큼 흔들렸다. 한 장으로 낸 부트스트랩 구간의 절반 폭은 7.4%로, 표준편차의 약 두 배다. 95% 구간이라면 그래야 한다. 30장 가운데 28장의 구간이 모집단 정답을 덮었다. 재기 오차가 없으면 부트스트랩은 제 몫을 한다.
측정한 값은 달랐다. '그대로' 잰 값은 30장 평균이 1,272 µm로 정답보다 31% 컸다. 사진끼리의 흩어짐은 ±4.7%로 정답 입자(±3.9%)와 크게 다르지 않았다. 그런데 부트스트랩 구간이 정답을 덮은 사진은 30장 가운데 한 장도 없었다. 구간은 흩어짐만 잰다. 측정이 한쪽으로 치우쳐 있으면 구간도 그 치우친 값 둘레에 놓인다.
거리 분수령은 +11%로 덜 치우쳤지만 구간이 정답을 덮은 것은 4장뿐이었다. 볼록도 버리기는 평균 −0.5%로 정답에 붙었고 29장이 덮었다. 9편에서 본 대로 이것은 버린 큰 입자와 남은 덩어리가 서로 상쇄된 결과다. 진짜 입자를 오려 붙인 가짜에서는 같은 방법이 +12%였다.
모아도 치우침은 남는다
사진을 여러 장 모으면 어떻게 될까. 처음 사진부터 차례로 1장, 2장, 3장, 5장, 10장, 20장, 30장을 합쳐 다시 계산했다.
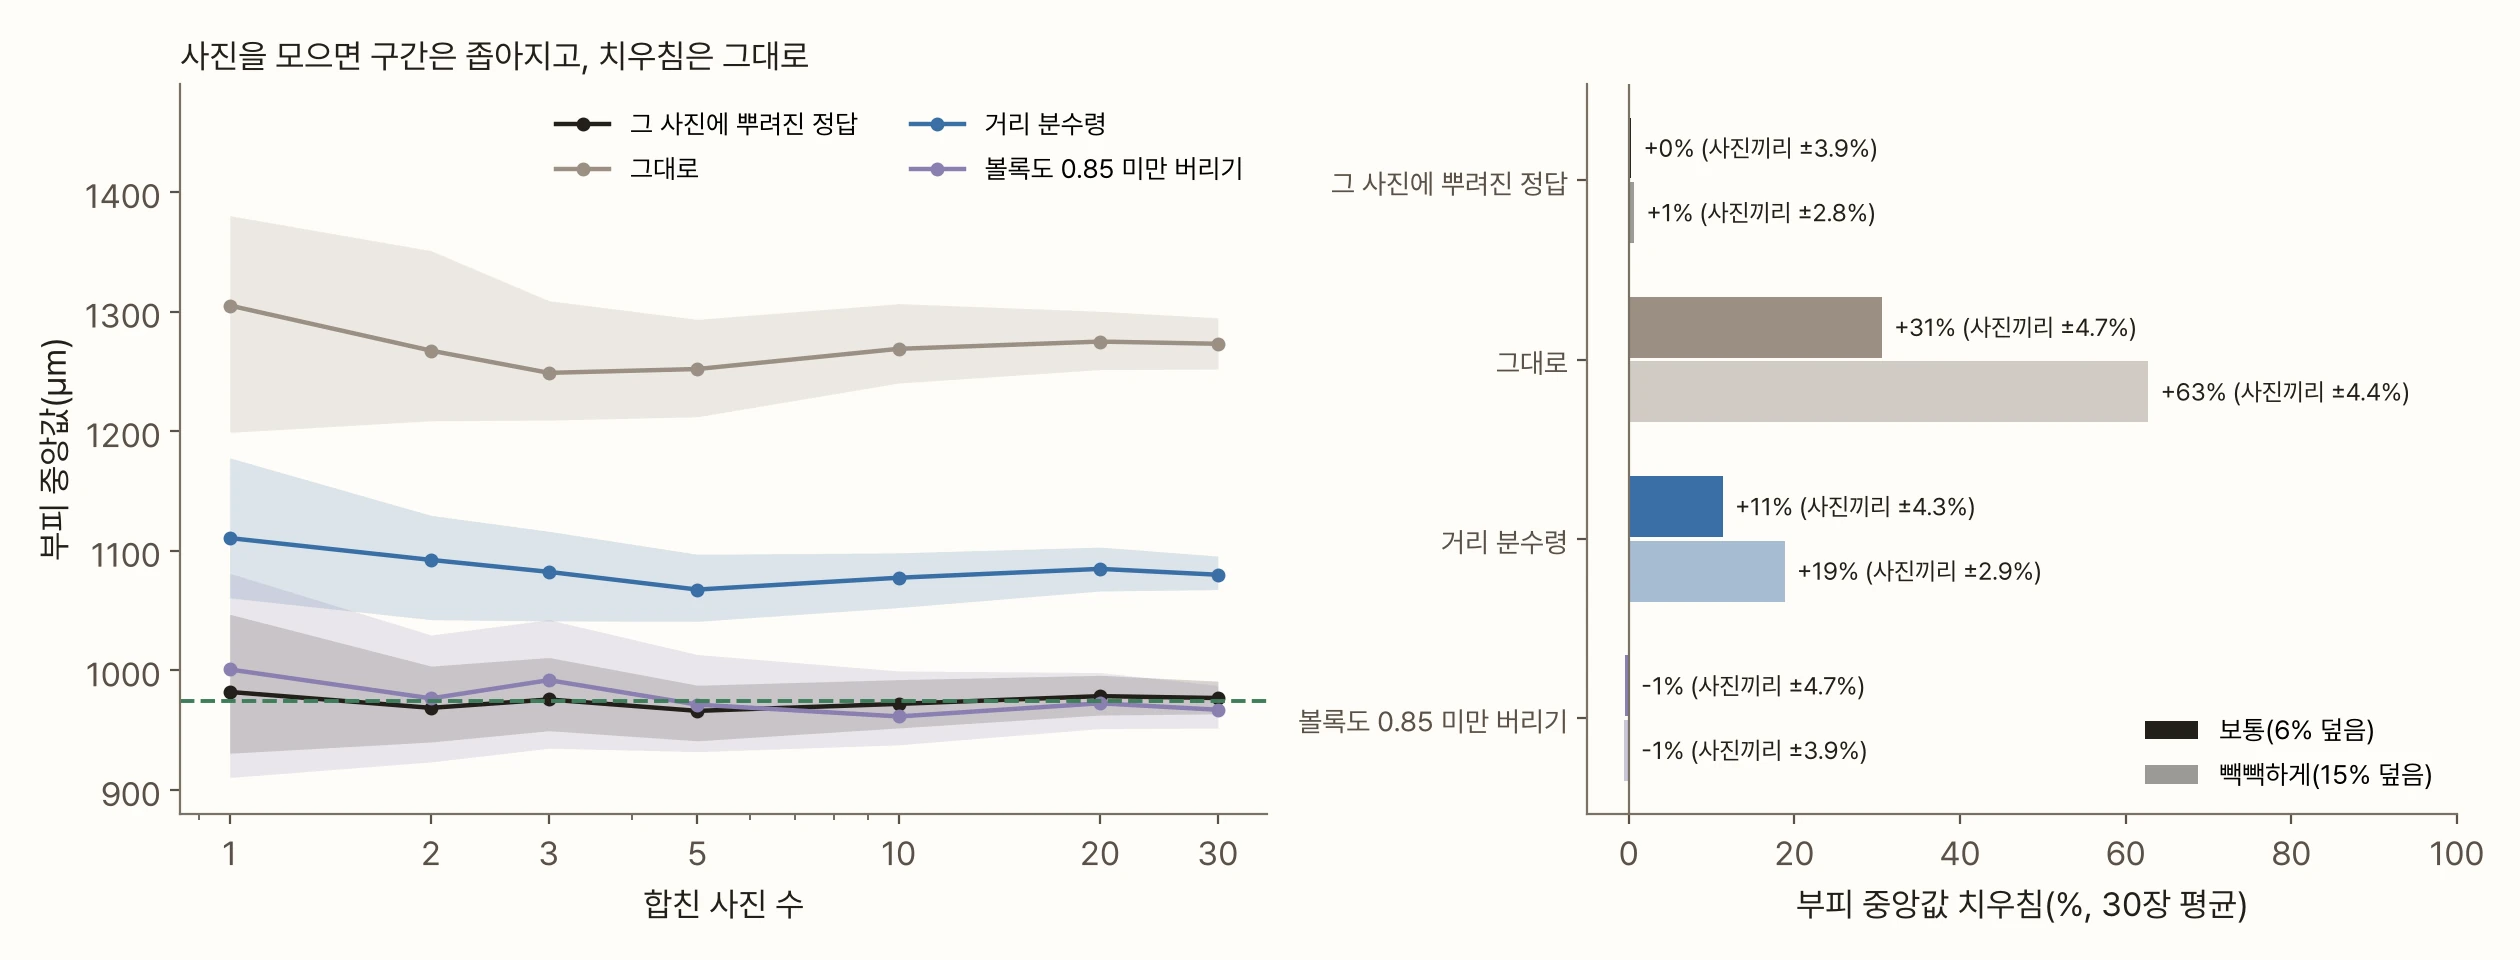
30장, 입자 3만 2천 개를 합치자 '그대로'의 구간은 1,252~1,295 µm로 좁아졌다. 정답 974 µm는 그 밖으로 한참 멀다. 사진을 모으면 구간이 좁아질 뿐 정답 쪽으로 움직이지는 않는다. 오히려 좁은 구간이 잘못된 값을 더 확신 있게 보여 준다.
오른쪽 그래프는 다른 길을 보여 준다. 사진 한 장에 더 많이 담으려고 가루를 빽빽하게(종이의 15%를 덮게) 뿌리면, 한 장의 정답 입자가 3,300개로 늘고 흩어짐은 ±3.9%에서 ±2.8%로 준다. 그 대신 '그대로' 잰 값의 치우침은 +31%에서 +63%로 두 배가 된다. 맞닿는 입자가 늘어나서다. ISO 13322-1이 한 화면의 입자 수를 조절해 맞닿은 입자를 줄이라고 하는 이유다. 입자를 많이 세려면 빽빽하게 뿌리지 말고 사진을 여러 장 찍어야 한다.
꼬집의 문제
지금까지는 봉지 속 가루가 잘 섞여 있다고 가정했다. 실제로는 그렇지 않을 수 있다. 가루를 담은 통을 흔들거나 옮기면 큰 입자는 위로, 작은 입자는 아래로 가르는 경향이 있다. 그러면 어디서 한 꼬집을 덜어 내느냐에 따라 표본이 달라진다. 이 오차는 꼬집 안에서 입자를 아무리 많이 세어도 줄지 않는다. 부트스트랩도 잡지 못한다.
말번의 시료 채취 백서는 앨런의 『입도 측정』에 실린 실험을 옮겨 둔다. 모래 두 가지를 60:40으로 섞은 시료를 여러 방법으로 나눠 조성을 쟀더니, 숟가락으로 떠낸 경우의 표준편차가 5.14%였다. 회전 분할기를 쓰면 0.146%로, 무작위로 섞였을 때의 이론값(0.075%)에 가까웠다. 백서는 업계에서 가장 흔한 "숟가락이나 주걱으로 떠내는" 방법이 5% 넘게 흔들린다고 적었다. 커피 가루에서 꼬집으로 덜 때 얼마나 갈리는지 잰 동료심사 연구는 찾지 못했다.
가이의 시료 채취 이론은 다른 쪽에서 같은 말을 한다. 시료가 모집단을 대표하는 데 필요한 무게는 가장 큰 입자 지름의 세제곱에 비례한다. 큰 입자일수록 하나의 무게가 커서, 몇 개가 들어오고 빠지는 데 따라 결과가 크게 바뀌기 때문이다. 앞에서 부피 중앙값이 큰 입자 240개에 달려 있던 것과 같은 이야기다.
ISO 13322-1의 처방은 단순하다. 시료를 적어도 셋으로 나눠 따로 재고, 그 결과를 비교해 반복성을 확인하라는 것이다. 그래야 채취와 분산 단계의 흔들림까지 들어간다. 가녜가 사진 12장을 시료 12개로 찍은 것도 같은 방식이다.
직접 해 보기
아래 시뮬레이션에서 '한 장 찍기'를 누를 때마다 사진 한 장이 한 줄로 쌓인다. 점은 그 사진의 값, 막대는 그 사진 하나로 낸 부트스트랩 95% 구간이다. 구간이 정답을 놓치면 점이 주황색이 된다.
'모집단에서 뽑기'에서는 손잡이로 한 장에 세는 입자 수를 바꿀 수 있다. 개수 중앙값에서 부피 중앙값, 부피 D90으로 바꾸면 같은 입자 수에서 흩어짐이 얼마나 넓어지는지 볼 수 있다. '가짜 사진 열 장 재기'에서는 같은 커피를 열 번 뿌린 가짜 사진을 방법마다 잰다. 맨 아래 굵은 줄은 그때까지 찍은 사진을 합친 값이다. '그대로'를 골라 열 장을 찍어 보면, 합친 줄이 정답에서 멀리 떨어진 채로 좁아진다.
이 실험이 빠뜨린 것
- 진짜 커피를 여러 번 찍지 않았다. 가녜 사진 한 장을 칸으로 나눠 본 것과 가짜 사진 30장이 전부다. 실제 사진끼리의 흩어짐에는 조명, 초점, 뿌리는 손버릇의 차이도 들어간다
- 꼬집 사이의 갈림은 재지 않았다. 봉지나 그라인더 받이 통에서 덜어 낼 때 크기가 얼마나 갈리는지는 커피에서 잰 자료를 찾지 못했다
- 분쇄 모델 하나만 썼다. 필요한 입자 수는 분포의 폭과 꼬리 길이에 크게 달려 있다. 에스프레소처럼 고운 분쇄나 꼬리가 긴 그라인더에서는 숫자가 달라진다
- 330 µm보다 작은 입자는 세지 않았다. 이 연재의 사진 배율(45.68 µm/px)에서는 넓이 40픽셀 미만 덩어리를 버리므로, 미분은 처음부터 빠져 있다. 미분은 개수가 많아서 뽑기 오차는 작지만, 3편에서 봤듯이 재기 오차가 크다
- 부트스트랩은 가장 단순한 백분위 구간만 썼다. 작은 표본에서 구간이 좁게 나오는 문제를 고치는 보정 방법(BCa 등)은 시험하지 않았다
- ISO 13322-1 부록 표는 원문을 보지 못했다. 호리바와 엔테그리스 자료에 옮겨 실린 표를 인용했다
정리
- 사진 한 장은 표본이다. 뽑기 오차는 입자를 많이 셀수록 줄지만, 재기 오차(치우침)는 줄지 않는다
- 부피로 세면 큰 입자 몇 개가 값을 쥔다. 가녜 사진에서 큰 것부터 240개(15%)가 부피의 절반이었고, 부피로 본 유효 표본 수는 1,561개 가운데 610개였다
- 이 연재의 분쇄 모델에서 ±5%(95%)에 닿으려면 개수 중앙값은 400개쯤, 부피 중앙값은 3,000~4,000개, 부피 D90은 20,000개 넘게 세야 한다. 폭을 절반으로 줄이려면 네 배를 세야 한다
- 한 장으로 낸 부트스트랩 구간은 측정이 정확할 때 실제 흩어짐과 잘 맞았다. 다만 입자 수백 개 이하에서는 구간이 실제보다 좁았다
- 가녜 사진을 열두 칸으로 나눈 흩어짐은 무작위로 뽑았을 때와 같았다. 한 꼬집 안에서는 크기가 갈려 앉지 않았다
- 같은 커피의 가짜 사진 30장을 '그대로' 재면 +31% 치우쳤고, 부트스트랩 구간은 한 번도 정답을 덮지 못했다. 30장을 합쳐도 구간만 좁아졌다
- 빽빽하게 뿌리면 한 장의 입자 수는 늘지만 치우침이 +31%에서 +63%로 커진다. 입자를 많이 세려면 사진을 여러 장 찍는 편이 낫다
오차 막대가 좁다는 것은 같은 방법으로 다시 재도 비슷한 값이 나온다는 뜻일 뿐이다. 그 값이 맞는지는 막대가 알려 주지 않는다.
참고문헌
- ISO 13322-1:2014. Particle size analysis — Image analysis methods — Part 1: Static image analysis methods — 4.1 개수·부피 기준과 분포 폭이 필요한 입자 수에 미치는 영향, 4.2 e) 따로 나눈 시료의 사진을 충분히 모을 것, 5.3 측정 영역에서 크기별 갈림 확인, 5.4 시료를 적어도 셋으로 나눠 반복성 확인. 부록 A(필요한 입자 수 어림)는 확인하지 못함. 공식 샘플
- Masuda H, Gotoh K (1999). Study on the sample size required for the estimation of mean particle diameter. Advanced Powder Technology 10(2), 159–173. doi:10.1016/S0921-8831(08)60447-160447-1) — 원문은 보지 못했고, 아래 두 자료에 옮겨 실린 표를 인용
- Bodycomb J (2013). Are we there yet? How many particles do you need for Image Analysis (TR021). HORIBA Scientific 웨비나 자료. PDF — ISO 13322-1 표(σg 1.6에서 ±5%에 6,092~60,811개), "ISO는 지나치게 보수적"
- Entegris. How Many Particles to Measure — AccuSizer system. 기술 노트. PDF — 같은 표와 '6만 개'의 출처
- Efron B (1979). Bootstrap methods: another look at the jackknife. Annals of Statistics 7(1), 1–26. doi:10.1214/aos/1176344552
- Künsch HR (1989). The jackknife and the bootstrap for general stationary observations. Annals of Statistics 17(3), 1217–1241. doi:10.1214/aos/1176347265 — 서로 상관된 자료의 블록 부트스트랩
- Kish L (1965). Survey Sampling. Wiley. — 유효 표본 수
- Eaton BC, Moore RD, MacKenzie LG (2019). Percentile-based grain size distribution analysis tools (GSDtools) – estimating confidence limits and hypothesis tests for comparing two samples. Earth Surface Dynamics 7, 789–806. doi:10.5194/esurf-7-789-2019 — 자갈 100개 ±15~30%, 500개 ±9~18%
- Malvern Panalytical. Sampling for Particle Size Analysis (WP051214). 링크 — 가이의 시료 무게와 지름의 관계, 앨런의 시료 나누기 방법별 표준편차(숟가락 5.14%, 회전 분할기 0.146%)
- Allen T (1997). Particle Size Measurement, 5th ed., Vol. 1. Chapman & Hall. — 위 백서를 통해 인용
- Petersen L, Minkkinen P, Esbensen KH (2005). Representative sampling for reliable data analysis: Theory of Sampling. Chemometrics and Intelligent Laboratory Systems 77(1–2), 261–277. doi:10.1016/j.chemolab.2004.09.013
- Gagné J. coffeegrindsize. GitHub. 링크 — 히스토그램 칸별 푸아송 오차 막대(
psd_hist_from_data), 평균 점의 가로 막대는 분포의 68% 폭 - Gagné J (2019). An App to Measure your Coffee Grind Size Distribution. Coffee ad Astra. 링크 — 본문과 댓글(작은 수의 통계가 첫째 한계, 시료 12개를 찍은 사진 12장 합성)
이미지 출처
- 모든 그림과 시뮬레이션: 직접 제작. 진짜 사진은 Jonathan Gagné의 coffeegrindsize 예시 사진(MIT 라이선스)이다