노래방 MR은 원곡에서 목소리만 지운 걸까 — 음원 분리 기술 50년, 같은 노래를 일곱 가지 방법으로 갈라 봤다
노래방 반주는 원곡에서 목소리를 지워 만든 게 아니다. 노래방 회사들은 지금도 귀로 받아 적어 반주를 새로 만든다. 섞인 소리는 다시 못 가른다는 게 오랜 상식이었는데, 그 상식이 지난 10년 사이에 무너졌다. 왼쪽 마이크에서 오른쪽을 빼던 1970년대 특허부터 행렬 분해, 딥러닝, 비틀스의 마지막 신곡까지 기술이 어떻게 바뀌었는지 짚었다. 같은 노래를 시대별 방법 일곱 가지로 직접 갈라 점수도 매겼다.
노래방 리모컨에는 「멜로디」 버튼이 있다. 누르면 반주 위에 노래 가락이 얹힌다. 예전부터 이게 신기했다. 원곡에서 목소리를 지운 거라면 가락만 다시 켜는 건 무슨 원리일까.
답은 싱겁다. 노래방 반주는 원곡에서 목소리를 지운 게 아니다. 처음부터 따로 만든다. 가락도 그때 같이 만들어 넣으니 켜고 끌 수 있다.
그런데 요즘은 사정이 다르다. 아이돌 음악방송 영상에서 반주를 걷어 내고 목소리만 남긴 「MR 제거」 영상이 돌고, 무료 프로그램 하나로 아무 노래에서 보컬을 뽑아낼 수 있다. 섞인 소리는 다시 못 가른다는 게 오랜 상식이었는데, 언제 어떻게 무너졌을까.
무엇을 하려 했나
음원 분리라는 분야가 어디서 출발해 어디까지 왔는지 정리하고 싶었다. 선도한 논문과 공개 리포, 실제로 쓰인 사례를 시대순으로 늘어놓는 것이다.
이번에는 글에 바로 돌려 보는 장치(데모)를 붙이기 어려웠다. 노래를 올려 갈라 주는 기능을 블로그에 심으면 남의 음원을 올리고 내려받는 통로가 된다. 그래서 대신 같은 노래를 시대별 방법으로 직접 갈라 보고, 점수와 그림을 예시로 싣기로 했다.
노래방 반주는 지운 게 아니라 다시 만든 것이다
TJ미디어는 2025년 회사 소개 글에서 반주 만드는 법을 밝혔다. 일반 반주는 컴퓨터 속 가상 악기로 만들고, 인기곡은 자체 스튜디오에서 세션 연주자가 기타·베이스·색소폰을 직접 연주해 녹음한다. 실연주 반주는 한 곡에 한 달 넘게 걸리고 비용도 일반 반주의 다섯 배가 넘는다. 매달 300곡 안팎을 이렇게 만든다.
금영도 같다. 2009년 한국일보 기사에 따르면 금영 제작팀은 악보 없이 음원을 귀로 들으며 음 높이와 박자를 뽑아냈고, 실제 반주자와 코러스가 낸 소리를 재료로 섞었다.
일본도 마찬가지다. 노래방 업체 JOYSOUND에서 30년 넘게 반주를 만든 가네코 노부히로는 2025년 인터뷰에서 지금도 CD를 사서 악기를 하나씩 귀로 들어 컴퓨터에 숫자로 입력한다고 했다. 한 곡에 빨라야 사흘이다. CD를 넣고 악기를 뽑으면 되지 않느냐는 질문에는 이렇게 답했다.
과일주스는 한번 믹서에 갈면 다시 사과와 귤로 나눌 수 없잖아요.
이유는 하나 더 있다. 레코드 회사는 원칙적으로 노래방 업체에 원곡 녹음 파일을 주지 않는다. 노래방 반주는 기술 때문에도, 권리 때문에도 새로 만들 수밖에 없는 물건이다.
참고로 「MR」은 한국에서만 쓰는 말이다. 매체마다 Music Record, Music Recording, Music Recorded로 다르게 풀어 써서 정확한 어원은 확인하지 못했다. 영어권에서는 instrumental, backing track, karaoke version이라고 한다.
첫 번째 방법: 가운데 소리를 빼라
믹서에 간 과일주스를 가르려는 시도는 생각보다 오래됐다. 가장 오래된 수법은 단순하다. 스테레오 녹음에서는 대개 목소리를 한가운데, 즉 왼쪽과 오른쪽 스피커에 똑같이 싣는다. 그러니 왼쪽 신호에서 오른쪽 신호를 빼면 가운데 있는 소리가 지워진다.
1973년 소니가 일본에 출원한 특허(미국 특허 3,941,931)가 이 원리로 가운데 목소리를 지우고 그 자리에 마이크 소리를 섞는 장치다. 이후 노래방 기계와 PC 프로그램의 「보컬 리무버」 기능이 대부분 이 방식이었다. 2009년 무렵 아이돌 가창력 논란을 키운 「MR 제거」 영상도 당시 기사에 따르면 "음색 조절 기능이 있는 프로그램"으로 만든 것이었다. 같은 기사들도 반주·코러스·함성은 100% 지워지지 않는다고 적었다.
문제는 한가운데 있는 게 목소리만이 아니라는 점이다. 베이스와 킥드럼도 보통 가운데에 둔다. MUSDB18이라는 연구용 데이터에는 곡마다 보컬·드럼·베이스·나머지 악기가 따로 들어 있다. 이 데이터의 시험용 50곡에 왼쪽 빼기 오른쪽을 걸고 악기별로 얼마나 남는지 재 봤다.
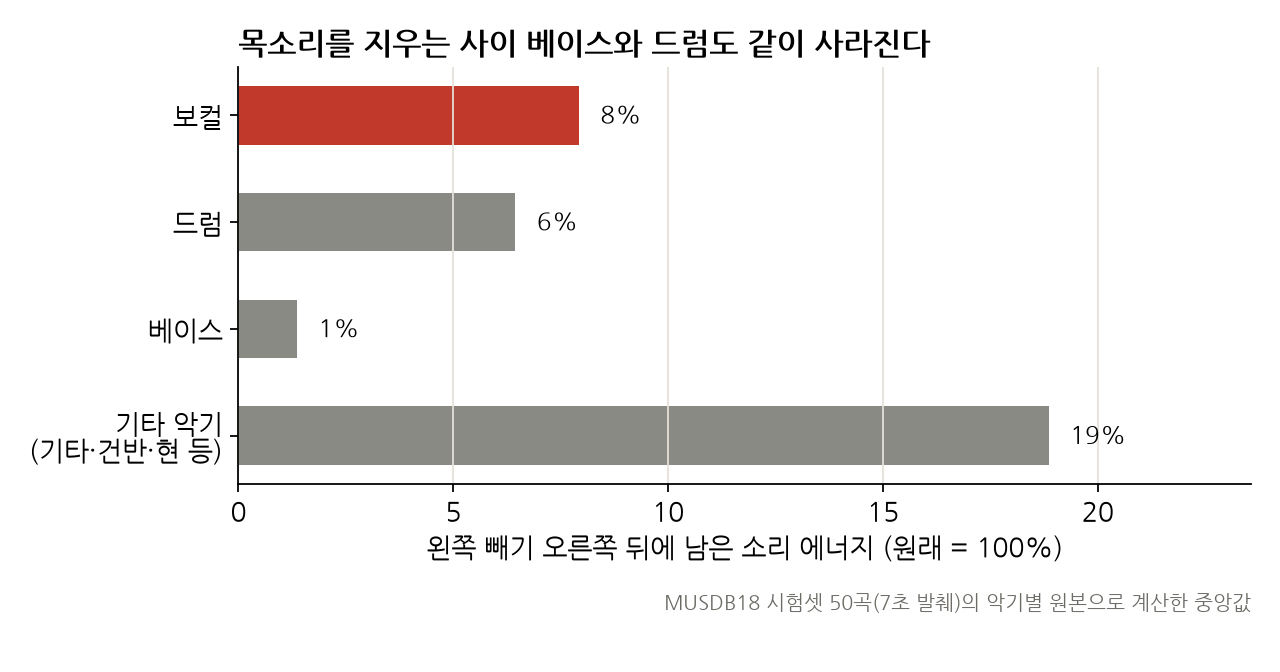
목소리가 8%만 남는 사이 베이스는 1%, 드럼은 6%만 남았다. 이 방법으로 만든 MR이 둥둥거리는 저음 없이 얇게 들리는 이유다. 목소리에 걸린 메아리(리버브)는 좌우로 퍼져 있어서 지워지지 않고 유령처럼 남는다. 결과물이 모노가 된다는 점도 1990년대 특허 문서에 이미 단점으로 적혀 있다.
수학으로 가르기: 칵테일파티에서 행렬 분해까지
시끄러운 파티에서도 내 이름을 부르는 소리는 귀에 들어온다. 1953년 영국의 콜린 체리가 이 현상을 실험으로 다뤘고, 이후 여러 소리가 섞인 데서 하나를 골라 듣는 문제를 「칵테일파티 문제」라고 부르게 됐다.
컴퓨터로 이 문제를 푸는 길은 크게 둘이었다.
- 독립 성분 분석(ICA, 1995). 벨과 세이노프스키가 제안했다. 마이크 여러 개에 소리가 다르게 섞여 들어오면, 서로 가장 무관해지도록 풀어서 원래 소리를 되찾는다. 다만 소리 개수만큼 마이크가 있어야 해서, 마이크 두 개로 녹음한 스테레오 음악에 악기가 열 개 넘게 들어 있으면 쓰기 어렵다.
- 비음수 행렬 분해(NMF, 1999). 리와 승현준(세바스찬 승)이 네이처에 낸 방법이다. 소리를 시간과 주파수로 펼친 그림(스펙트로그램)을 「음색 몇 개」와 「그 음색이 언제 울리는지」로 쪼갠다. 2003년 스마라그디스와 브라운이 이걸 피아노 악보 받아 적기에 썼고, 2007년 비르타넨이 음악 분리용으로 다듬었다.
2010년 전후로는 음악의 성질을 이용하는 방법이 나왔다. 반주는 같은 마디를 되풀이하고 목소리는 그렇지 않다는 점을 이용한 REPET(라피·파르도, 2012), 반주는 단조롭고 목소리는 드문드문 튄다고 본 RPCA(황 외, 2012), 드럼처럼 순간 터지는 소리와 길게 끄는 소리를 가르는 HPSS(피츠제럴드, 2010)가 그렇다.
이 시기 방법들은 사람이 규칙을 정했다. 규칙이 들어맞는 곡에서는 그럴듯했지만, 반주가 매 마디 바뀌거나 목소리가 길게 끌리면 무너졌다.
정답지가 생기자 딥러닝이 들어왔다
딥러닝으로 넘어가는 데 결정적이었던 건 알고리즘보다 정답지였다. 섞인 곡과 그 곡의 악기별 원본을 같이 갖고 있어야 기계에게 "이렇게 갈라라"를 가르칠 수 있다.
- 2006년 뱅상·그리보날·페보트가 분리 품질을 재는 점수 SDR을 정했다. 정답 소리 대비 섞여 남은 잡음이 얼마나 작은지를 데시벨로 나타낸 값이다. 3 dB 오르면 잡음 에너지가 절반으로 준다
- 2017년 말 MUSDB18이 공개됐다. 150곡(학습 100, 시험 50)에 보컬·드럼·베이스·나머지 네 갈래가 따로 들어 있다. 이후 거의 모든 논문이 같은 시험 50곡으로 점수를 낸다
그다음은 빨랐다.
- 2017, U-Net (스포티파이·런던시티대). 이미지에서 물체 윤곽을 따던 신경망 구조를 스펙트로그램에 썼다. 원곡과 그 곡의 반주(인스트루멘털) 버전 2만 쌍 가까이로 학습했다
- 2019, Open-Unmix (인리아·소니). 누구나 다시 돌려 볼 수 있게 코드와 학습 가중치를 공개한 기준 모델
- 2019, Spleeter (디저). 프로그램 한 줄로 2·4·5갈래 분리를 해 준 공개 도구. 그래픽카드 한 장으로 실제 길이보다 100배 빨리 갈랐다. 일반인이 「AI 보컬 제거」를 처음 접한 게 대개 이것이었다
- 2019~2022, Demucs (페이스북·메타). 스펙트로그램이 아니라 소리 파형을 직접 다루는 쪽에서 출발해, 두 방식을 섞은 Hybrid Demucs가 2021년 소니가 연 음원 분리 대회(MDX 2021)에서 우승했다. 2022년 트랜스포머를 붙인 HT Demucs가 나왔다
- 2023, BS-RoFormer (바이트댄스). 주파수를 여러 띠로 잘라 띠마다 트랜스포머로 본다. 2023년 대회(SDX 2023)에서 1위를 했고, 지금 공개 분리 도구들의 기본 모델이 이 계열이다
- 2025, SAM Audio (메타). 「기타만」처럼 글로 원하는 소리를 지정하거나 영상 속 물체를 찍어서 그 소리만 뽑는다. 음악 네 갈래라는 틀을 벗어나는 흐름이다
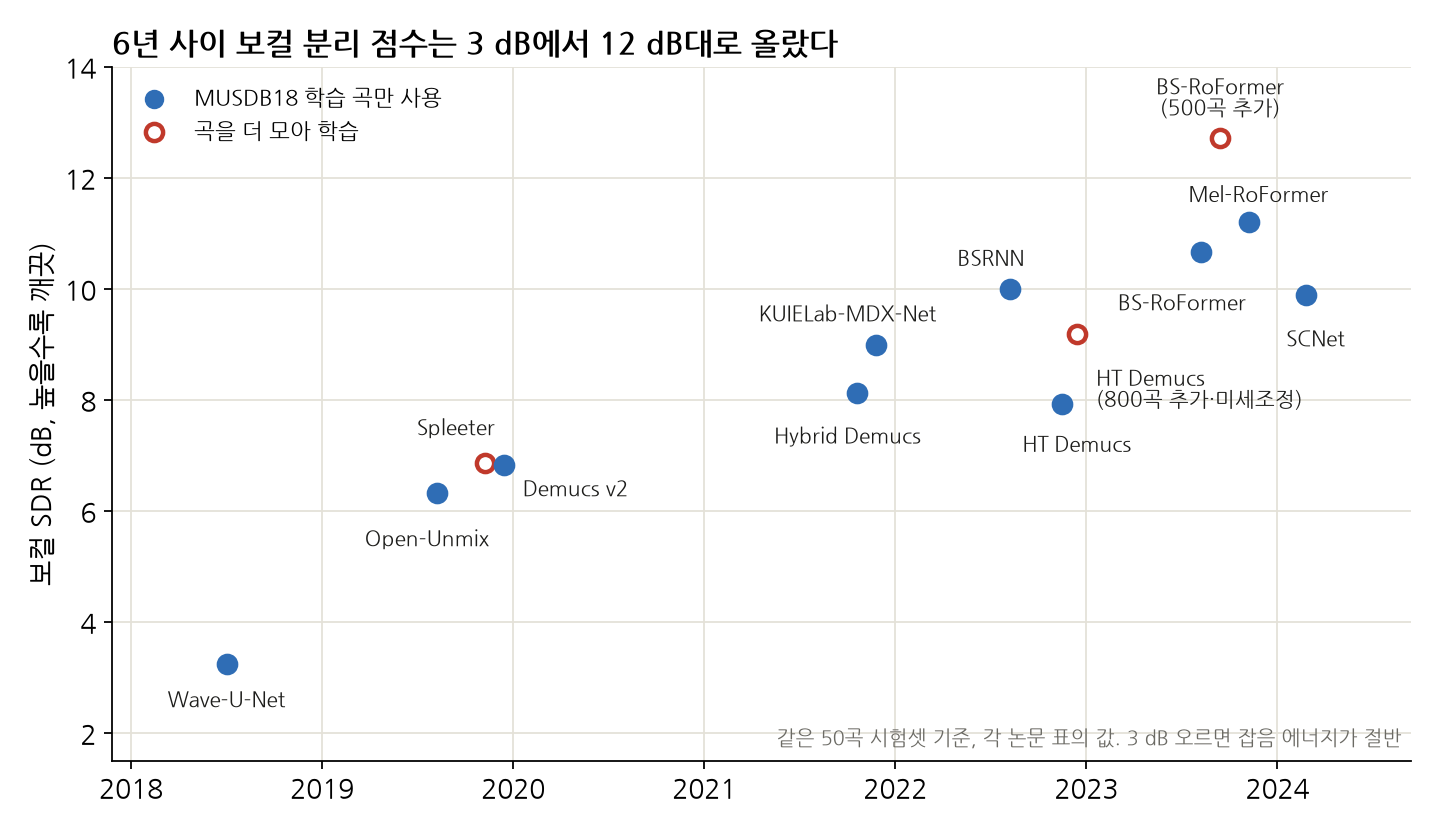
각 논문 표에 실린 MUSDB18 시험셋 보컬 점수다. 2018년 3 dB대에서 2023년 12 dB대로 올랐다. 잡음 에너지로 치면 대략 8분의 1로 준 셈이다. 빨간 테두리는 MUSDB18 밖의 곡을 더 모아 학습한 경우다. 같은 구조라도 곡을 더 넣으면 0.5~1 dB 오르고, 모델을 키우면서 곡도 더 넣은 BS-RoFormer는 2 dB 넘게 올랐다. 이 분야의 경쟁이 상당 부분 학습 데이터 경쟁이라는 뜻이다.
직접 써 볼 수 있는 공개 리포
| 리포 | 무엇인가 | 스타(2026-10) | 라이선스 |
|---|---|---|---|
| deezer/spleeter | 2019년 대중화의 시작. 지금은 성능이 뒤처진다 | 2.8만 | MIT |
| Anjok07/ultimatevocalremovergui | UVR. 여러 모델을 골라 쓰는 윈도·맥 프로그램. 사실상 표준 | 2.7만 | MIT |
| facebookresearch/demucs | Demucs 원본. 보관(archive) 처리됐고 저자 개인 포크 adefossez/demucs가 이어 받았다 | 1만 | MIT |
| CarlGao4/Demucs-Gui | Demucs를 창 하나로 쓰게 만든 프로그램 | 1,200 | GPL-3.0 |
| ZFTurbo/Music-Source-Separation-Training | RoFormer 계열을 직접 학습시키는 코드 모음 | 1,600 | MIT |
| nomadkaraoke/python-audio-separator | UVR 모델들을 파이썬 한 줄로 부르는 도구. 이번 실험에 썼다 | 1,400 | MIT |
| sigsep/open-unmix-pytorch | 연구용 기준 모델 | 1,500 | MIT |
같은 노래를 일곱 가지 방법으로 갈라 봤다
노트북(그래픽카드 RTX 3070)에서 MUSDB18 시험 50곡의 7초 발췌본을 시대별 방법 일곱 가지로 갈랐다. 정답 원본이 있으니 점수를 바로 매길 수 있다. 점수는 2021년 대회 방식대로 곡 전체 SDR을 쓰고 50곡의 중앙값을 냈다.
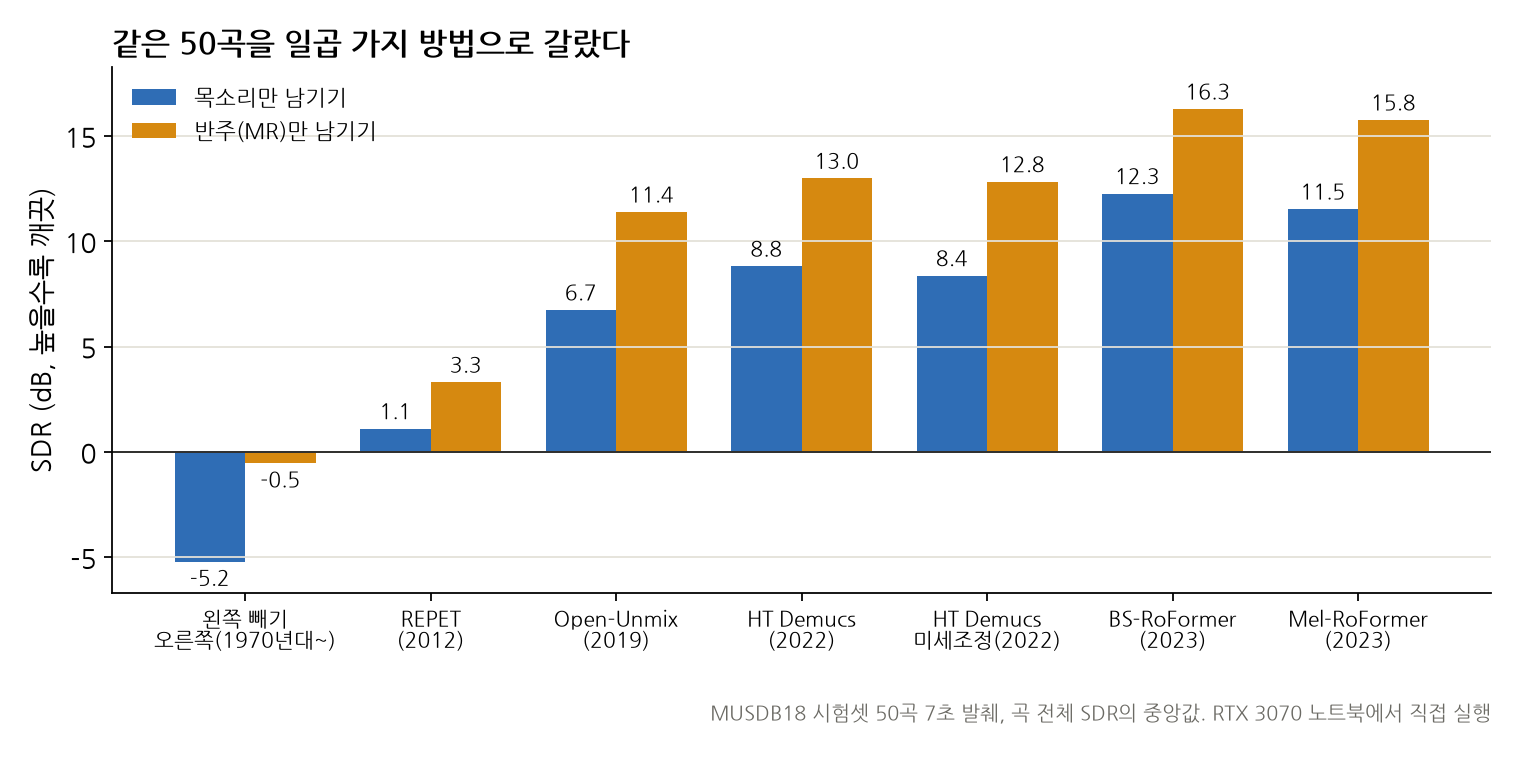
기준을 하나 먼저 잡아 두면 읽기 쉽다. 아무것도 안 하고 원곡을 그대로 「MR」이라고 내놓아도 반주 점수는 4.5 dB가 나온다. 원곡에서 반주가 목소리보다 크기 때문이다.
- 왼쪽 빼기 오른쪽은 반주 점수가 -0.5 dB다. 아무것도 안 한 것(4.5 dB)보다 5 dB 낮다. 목소리를 덜어 낸 것보다 베이스와 드럼을 깎아 낸 손해가 더 컸다는 뜻이다
- 규칙으로 가르는 REPET는 3.3 dB. 이것도 기준선을 못 넘었다. 7초짜리 발췌라 되풀이되는 마디를 찾을 시간이 짧았던 탓도 있다
- 딥러닝으로 넘어간 Open-Unmix(2019)에서 11.4 dB로 뛰었다. 기준선보다 7 dB, 잡음 에너지로 5분의 1이다
- 지금 공개 도구의 기본값인 BS-RoFormer는 보컬 12.3 dB, 반주 16.3 dB. 2019년 모델보다 다시 5 dB 높다
두 가지는 덧붙여 둔다. 미세조정한 HT Demucs가 기본판보다 낮게 나왔는데(8.4 대 8.8), 7초짜리 50곡이라 이 정도 차이는 곡 몇 개로 뒤집힌다. 평균으로 보면 순서가 거꾸로다(8.5 대 8.4). 그리고 BS-RoFormer 점수(12.3)는 논문 값(12.7)과 비슷하지만, 이번에 쓴 가중치는 논문 저자가 아니라 커뮤니티가 학습해 공개한 것이고 무엇으로 학습했는지 밝혀져 있지 않다. 시험곡이 학습에 들어갔다면 점수가 부풀었을 수 있다.
점수만으로는 감이 안 와서, 소리를 그림으로 펼쳤다. 가로가 시간, 세로가 음 높이, 밝을수록 소리가 크다. 이 노래는 가수가 목소리 트랙을 따로 공개해 둔 곡이라 비교 대상이 있다(ccMixter, Mr_Yesterday 「Sins of the Fathers」, CC BY 3.0).
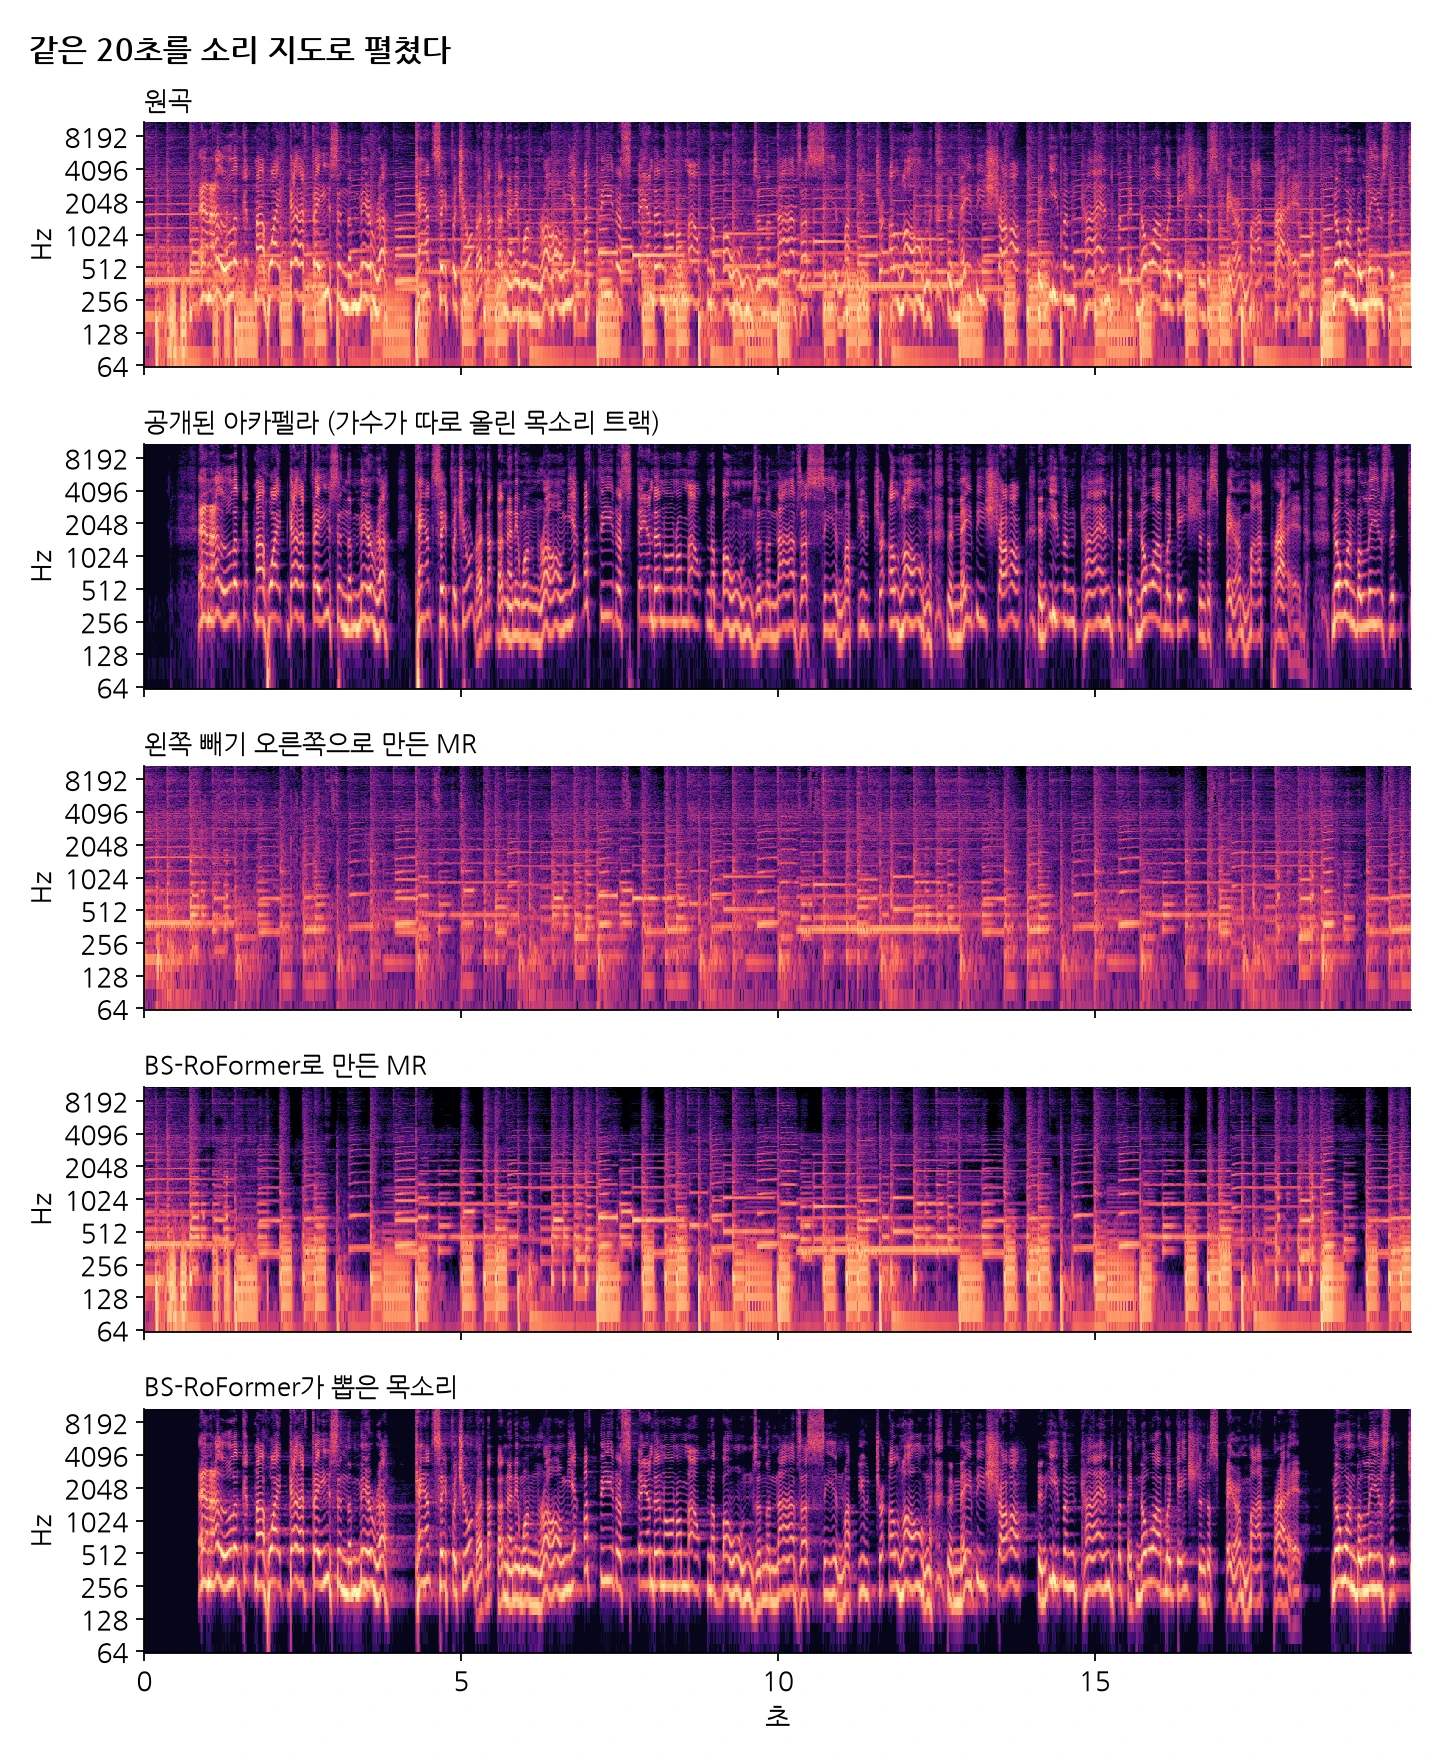
원곡(맨 위)에서는 목소리의 물결무늬와 악기의 가로줄이 겹쳐 있다. 공개된 아카펠라(둘째)와 BS-RoFormer가 뽑은 목소리(맨 아래)는 첫 1초의 빈자리, 물결 모양, 숨 쉬는 틈까지 거의 같다. 왼쪽 빼기 오른쪽(셋째)은 목소리 물결이 대부분 사라졌지만 128Hz 아래 저음도 함께 어두워졌다. BS-RoFormer의 MR(넷째)은 맨 아래 저음 띠가 원곡처럼 밝게 남아 있고 물결무늬만 빠졌다.
어디서 틀렸나
최신 모델 두 개가 목소리를 「무음」으로 내놨다. BS-RoFormer와 Mel-RoFormer를 처음 돌렸더니 50곡 모두 보컬 점수가 정확히 0이었다. 목소리 파일이 텅 비어 있었던 것이다. 처음에는 7초 클립이 모델이 한 번에 보는 길이(약 8초)보다 짧은 탓이라고 보고 뒤에 무음을 붙여 20초로 늘렸다. 그대로였다. 20초짜리 예시곡도 똑같이 비어 나왔다. 결국 분리 도구(audio-separator)를 거치지 않고, 모델을 만든 쪽의 원래 코드로 같은 가중치를 직접 불러 해결했다. 이상하다고 알아챈 단서는 반주 점수였다. 4.5 dB로, 원곡을 그대로 낸 기준선과 같았다. 「아무것도 안 했다」는 뜻이다.
소리 지도의 한 칸이 새카맣게 나왔다. 왼쪽 빼기 오른쪽으로 만든 MR의 그림이 완전히 검었다. 그림을 그리려고 왼쪽과 오른쪽 채널을 평균 냈는데, 이 방식의 출력은 왼쪽이 L-R, 오른쪽이 R-L이라 둘을 더하면 정확히 0이 된다. 실제 소리에는 문제가 없었고, 그림만 한 채널로 다시 그렸다.
공개 아카펠라는 정답이 아니었다. 예시곡은 가수가 목소리 트랙을 따로 올려 둔 곡이라 그걸 정답 삼아 점수를 내려 했다. BS-RoFormer가 뽑은 목소리를 아카펠라에 대 보니 -6.8 dB가 나왔다. 그림으로는 거의 같은데 점수는 형편없다. 믹스에 들어간 목소리는 공개된 아카펠라와 음량도 다르고 다른 처리도 거친 소리라, 파형 단위로는 맞지 않는다. 그래서 이 곡은 그림으로만 쓰고 점수는 정답 원본이 확실한 MUSDB18로만 냈다.
설치에서 세 번 막혔다. 분리 도구가 요구하는 부품 하나(diffq)가 C 컴파일러를 찾다가 설치에 실패했고, 그 부품 없이 Demucs를 부르는 경로가 막혀 Demucs는 따로 불렀다. 모델 가중치를 받는 동안 진행이 멈춘 줄 알고 내가 중간에 끊었다가 다시 받기도 했다. 작업이 끝나기를 기다리는 대기 스크립트가 자기 자신을 「아직 도는 작업」으로 세는 바람에 30분을 그냥 기다린 일도 있었다.
지금 어디에 쓰이나
아이돌 음악방송 MR 제거. 2009년 무렵부터 음악방송 영상에서 반주를 걷어 낸 영상이 가창력 논란을 키웠다. 그때는 가운데 빼기 수준이라 반주와 함성이 많이 남았다. 지금은 공개 도구로도 그때보다 훨씬 깨끗하게 걷힌다. 다만 함성과 방송 압축이 섞인 음원은 아래 실험 점수보다 한참 낮다. 반대로 2014년 엠넷 「음담패설」은 방송 음원과 원곡을 맞대어 립싱크를 가려내기도 했다.
비틀스의 마지막 신곡. 2023년 나온 「Now and Then」은 존 레논이 1970년대 말 집에서 피아노를 치며 녹음한 카세트가 바탕이다. 목소리와 피아노가 한 트랙에 붙어 있어서 1990년대에는 완성하지 못했다. 피터 잭슨의 다큐멘터리 「겟 백」(2021)을 만들며 모노 녹음에서 악기와 사람 목소리를 하나하나 떼어 내는 기술(MAL)을 개발했고, 같은 팀이 그 기술로 레논의 목소리를 피아노에서 떼어 냈다. 2022년 앨범 『Revolver』 재발매판도 4트랙 테이프를 이 기술로 다시 갈라 새로 섞었다.
스트리밍 앱의 노래방 모드. 애플 뮤직은 2022년 12월 「Apple Music Sing」을 내며 노래의 목소리 크기를 줄였다 키웠다 하게 했다. 보도자료 각주에 "목소리를 완전히 지우지는 않는다"고 적었다.
음악 작업 도구. 애플 로직 프로는 2024년 5월부터 어떤 녹음이든 드럼·베이스·보컬·나머지 네 갈래로 나누는 기능을 기본으로 넣었다. 디제이 프로그램 djay(2020)와 세라토(2022)는 공연 중에 실시간으로 보컬만 빼고 튼다. 연주 연습 앱 모이세스(Moises)는 2023년 등록 사용자 3천만 명을 넘겼다.
영화와 더빙. 오디오셰이크는 2024년 영화 소리를 대사·음악·효과음으로 가르는 서비스를 내놨다. 원본 작업 파일이 남아 있지 않은 옛 영화를 다른 나라 말로 더빙할 때, 대사만 걷어 내고 음악과 효과음을 살리는 데 쓴다.
그리고 노래방. 국내 오디오 기업 가우디오랩은 2024년 인터뷰에서 일본의 유력 노래방 업체와 분리 기술을 시험했다고 밝혔다. 곡의 90% 정도는 쓸 만하고 10%는 상용화하기에 아쉽다고 했다. 과일주스를 다시 가르는 일이 노래방 업계에서도 현실적인 선택지가 되기 시작했다.
갈 수 있다고 올려도 되는 건 아니다
기술이 쉬워진 만큼 조심할 자리가 있다.
- 원곡에서 뽑은 MR이나 목소리는 원곡 녹음의 소리를 그대로 쓴 것이다. 작사·작곡자의 권리에 더해 가수와 연주자(실연자), 음반을 만든 회사(음반제작자)의 권리가 그대로 걸린다(저작권법 69·78·81조). 집에서 혼자 노래 연습에 쓰는 것과 인터넷에 올리는 것은 다른 문제다
- 노래방 반주도 따로 보호받는다. TJ미디어는 자사 반주기를 허락 없이 써서 영상을 만든 유튜버를 상대로 1·2심에서 이겼고, 2심 배상액은 4,800여만 원이었다. "반주는 원곡을 단순히 베낀 것이라 음반이 아니다"라는 주장은 받아들여지지 않았다(2026년 3월 기준 대법원 상고 중)
- 유튜브는 기성 반주를 깐 커버를 수익 공유 대상에서 뺀다. 고객센터 정책에 "instrumental, karaoke recording" 같은 상업 녹음을 쓴 커버는 수익화할 수 없다고 적혀 있다. 원곡에서 뽑은 MR이 콘텐츠 ID에 걸리는지는 공식 문서로 확인하지 못했다. 다만 원곡 녹음의 반주를 그대로 담고 있으니 걸릴 가능성이 높다고 보는 게 맞다
왜 한 줄로 되는가
이번 일은 AI가 새로 발명한 것이 거의 없다. 공개 데이터(MUSDB18), 공개 모델(Demucs, RoFormer 계열), 공개 도구(audio-separator, 모델 학습 코드 리포)가 이미 다 있었고, AI는 그것들을 설치하고 이어 붙이고 점수를 매기는 일을 했다. 설치에서 세 번 막혔고, 최신 모델 두 개는 엉뚱한 결과를 내서 다시 돌렸다. 조사를 빼고 실험부터 그림 다섯 장까지 두 시간 남짓 걸렸다.
이 분야가 딸깍이 되는 이유는 결국 앞에서 본 정답지다. 정답이 있는 문제는 점수로 비교할 수 있고, 점수로 비교할 수 있는 문제는 10년 사이 논문과 대회가 끝까지 밀어붙인다. 그 결과가 리포 하나로 공개돼 있으니 남은 일은 설치뿐이다.
따라 하려면
- 쓸 목적부터 정하라. 노래 연습용 MR이면 반주 쪽 점수가 높은 모델을, 목소리만 들으려면 보컬 전용 모델을 고른다. 코러스를 남기고 리드 보컬만 지우는 「노래방(karaoke)」 전용 모델도 따로 있다
- 정답이 있는 곡으로 먼저 재 보라. 가수가 아카펠라나 악기 트랙을 공개한 곡(ccMixter 등)으로 돌려 보면 내 귀가 아니라 숫자로 비교할 수 있다
- 「아무것도 안 했을 때」 점수를 먼저 재 두라. 원곡을 그대로 낸 점수와 결과 점수가 같으면 모델이 실제로는 아무것도 안 한 것이다. 이번에 무음 출력을 잡은 게 이 비교였다
- 옛 방법도 한 번 같이 돌려 보라. 왼쪽 빼기 오른쪽 결과를 옆에 두면 새 모델이 무엇을 해결했는지가 들린다
못 하는 것
- 완벽하게 가르지는 못한다. 가장 좋은 모델도 목소리가 크게 지르는 자리에서는 반주에 숨소리와 자음이 비친다. 목소리와 같은 음을 같이 연주하는 악기가 있으면 둘을 헷갈린다
- 녹음 상태가 나쁘면 크게 떨어진다. 이번 점수는 깨끗한 스튜디오 음원 기준이다. 공연장 함성, 방송 압축, 휴대폰 직캠은 점수가 훨씬 낮다
- 코러스·화음은 애매하다. 대부분의 모델은 모든 사람 목소리를 「보컬」로 묶는다. 노래방처럼 코러스는 남기고 싶다면 전용 모델이 따로 필요하다
- 권리는 해결해 주지 않는다. 기술적으로 갈렸다고 해서 남의 녹음을 쓸 수 있는 건 아니다
노래방 회사들이 지금도 귀로 받아 적어 반주를 만드는 이유는 기술보다 권리와 품질 쪽이 크다. 그래도 과일주스는 이제 가를 수 있다. 다음에 노래방 리모컨의 「멜로디」 버튼을 누를 때는, 저 가락을 누군가 한 음씩 받아 적었다는 것도 떠올려 보자.
재미있게 읽었다면 꼭 의견을 달아달라.
출처
- 대표 사진: 금영 노래방 리모컨, Catherine(Flickr), CC BY 2.0 (위키미디어 커먼즈.jpg))
- 소리 지도 예시 곡: "Sins of the Fathers" by Mr_Yesterday (ccMixter), CC BY 3.0. 20초 발췌, 음원 분리 실험에 사용
- 노래방 반주 제작: TJ미디어 「TJ 노래방 음악, 이렇게 만든다고?」(2025), 한국일보 「(주)금영 콘텐츠연구소 제작팀」(2009), ORICON NEWS JOYSOUND 인터뷰(2025)
- MR 제거 영상: 매일신문(2009-02-20), 재경일보(2009-02-18), 텐아시아 「음담패설」(2014)
- 가운데 빼기 특허: US 3,941,931 (Sony, 1973 출원), 모노 출력 단점은 US 5,550,920 (Mitsubishi)
- 기술사: Cherry (1953) JASA · Bell & Sejnowski (1995) ICA · Lee & Seung (1999) NMF · Smaragdis & Brown (2003) 링크 · Virtanen (2007) 링크 · FitzGerald (2010) HPSS · Rafii & Pardo (2013) REPET · Huang et al. (2012) RPCA
- 평가와 데이터: Vincent et al. (2006) BSS Eval · MUSDB18 · SiSEC 2018 · MDX 2021 · SDX 2023
- 딥러닝: U-Net (Jansson et al. 2017) · Wave-U-Net · Open-Unmix · Spleeter · Demucs v2 · Hybrid Demucs · KUIELab-MDX-Net · BSRNN · HT Demucs · BS-RoFormer · Mel-RoFormer · SCNet · SAM Audio
- 연도별 점수 그림: Wave-U-Net·Open-Unmix·Spleeter·Demucs v2는 Demucs v2 논문 표 1, Hybrid Demucs는 원 논문 표 3, KUIELab·BSRNN·HT Demucs는 HT Demucs 논문 표 1, BS-RoFormer는 원 논문 표 2, Mel-RoFormer는 원 논문 표 1, SCNet은 원 논문 표 2. 2019년 이전 값은 MUSDB18, 이후는 MUSDB18-HQ(같은 곡의 무압축판) 기준
- 사례: 비틀스 「Now and Then」 발표 · 『Revolver』 재발매 · Apple Music Sing · Logic Pro Stem Splitter · djay Neural Mix · Serato Stems · Moises 사용자 수(MBW) · AudioShake 대사·음악·효과 분리 · 가우디오랩 인터뷰(바이라인네트워크)
- 저작권: 저작권법 69조 · 78조 · 81조 · 30조, TJ미디어 반주 소송 2심(헤럴드경제, 2026-03-04), 유튜브 커버 수익화 정책
- 이 글의 실험 점수와 그림은 모두 직접 계산했다. MUSDB18은 학술용 데이터라 소리와 곡별 그림은 싣지 않았다