패널 알바를 구하지 않고도 AI 소비자 조사를 한다 — AI 합성 패널의 쓸모와, 서베이 산업이 겁내는 자기잠식
AI 코드 몇 줄로 소비자 조사를 시켜 봤다. "30대 직장인 여성에게 이 신제품 콘셉트를 어떻게 보는지 물어보시오." 몇 분 뒤에 응답자 프로필, 구매 의향 분포, 가격 민감도, 자유 응답까지 붙은 리포트 한 장이 나왔다. 단, 실제로는 어떤 사람도 그 질문에 답하지 않았다. 답한 건 사람이 아니라 미리 만들어 둔 가짜 소비자 3만 명이었다.
이번 회는 앞 회차들과 결이 조금 다르다. 지금까지는 한 번에 끝난 물건 하나를 풀었는데, 이번 건 몇 달에 걸쳐 만든 도구고, 쓰는 사람 입장에서 한 줄로 딸깍 되는 게 핵심이다. 말하자면 솔루션 같은 제품이라는거다. 그리고 더 나아가 종래의 설문조사 산업이 지금 이런 사례들을 보면서 어떤 일을 겪고 있는지를 같이 확인해봤다. 벌써부터 흥미롭지 않나.
무엇을 물었나
실제로 넣은 건 이런 문장이다.
30대 후반 수도권 직장인 여성 집단에게 새 저당 요거트 콘셉트를 보여주고, 사 먹을 의향이 있는지, 얼마면 비싸다고 느끼는지, 왜 망설이는지를 물어봐 주시오.
질문 자체는 상당히 단순하지만, 제품의 컨셉과 명칭 그리고 가격 등 다양한 정보를 자유롭게 넣었다. 타겟 소비자 역시 어느정도 한정해 넣는 것도 키포인트가 될 수 있겠다.
무엇이 나왔나
응답자 200명이 자동으로 뽑히고, 각자 콘셉트 설명을 읽고 답한 리포트가 나온다. 구매 의향은 5점 척도로 분포가 잡히고, 「얼마부터 비싸다고 느끼는가」는 가격대별 곡선으로, 망설이는 이유는 자유 응답을 묶어 몇 갈래로 정리된다. 성별·연령·지역으로 쪼갠 교차표도 붙는다.
여기까지는 진짜 설문조사 리포트와 겉모습이 같다. 다른 건 딱 하나, 응답자가 사람이 아니라는 것. 그 차이가 이 글 전체의 주제다.
사람 대신 누가 답하나 — 네오페르소나
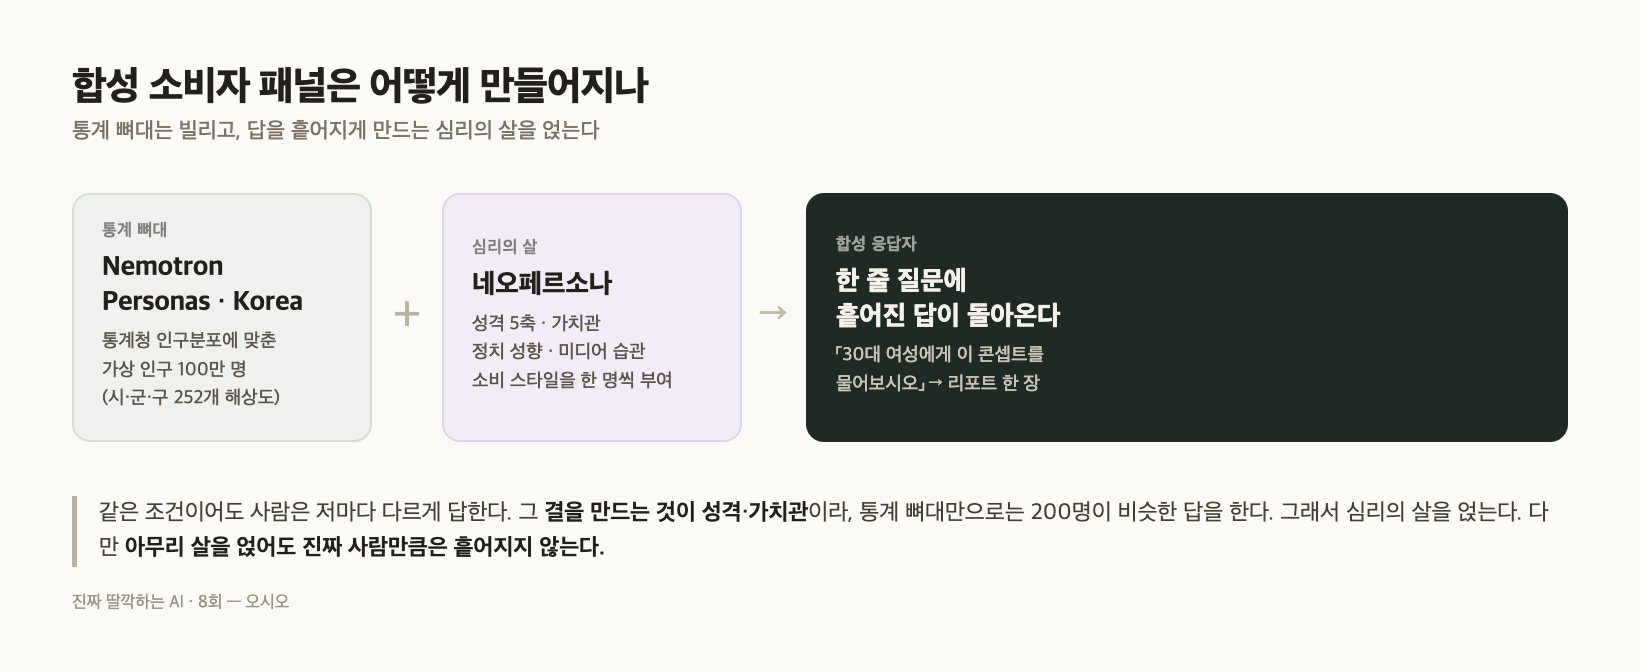
답하는 건 미리 만들어 둔 가짜 사람들이다. 나는 이 서비스에서 이 가상의 인물들을 네오페르소나라고 불렀다. 약 3만 명 규모로, 한 명 한 명이 나이·성별·지역·직업 같은 겉 속성만 있는 게 아니라 성격(외향성·개방성 같은 다섯 축), 정치 성향, 가치관, 미디어 습관, 소비 스타일까지 얹혀 있다. 조사할 때는 이 3만 명 중에서 조건에 맞는 사람들을 뽑아 각자에게 질문을 던지고, 그 답을 모은다.
왜 겉 속성만으로는 부족한가. 「35세 서울 여성」이라는 정보만 주면 언어모델은 그 자리에서 가장 평균적인 35세 서울 여성을 지어낸다. 그러면 200명을 물어도 200명이 비슷한 답을 한다. 전제 자체가 편향을 만들어 내는 현상이 강하게 일어나면서 뻔한 결과만 나오게 되는 문제가 있다. 그런데, 실제 리서치를 해보면 사람은 대체로 같은 조건이어도 누구는 신제품을 좋아하고 누구는 의심한다. 그 결을 만드는 게 성격·가치관 같은 속성이라, 그런것을 반영해 응답할 수 있도록 하는 것이 묘미다.
100만 명은 어디서 왔나 — Nemotron
3만 명은 우리가 언어모델로 하나씩 만든 것이라 비용도 시간도 든다. 더 넓게 가려면 밑재료가 필요했는데, 엔비디아(NVIDIA)가 2026년 4월 공개한 Nemotron-Personas-Korea 데이터셋이 그 재료가 됐다.
네모트론은 한국인 가상 인물 100만 명분의 프로필이다. 그냥 지어낸 게 아니라 통계청 인구 분포에 맞춰 만들었다는 게 핵심이다. 만드는 방식이 흥미로운데, 먼저 확률 그래프 모델이라는 통계 장치로 「이 나이·이 지역이면 이런 직업·학력·혼인 상태일 확률」을 실제 인구 통계에 맞게 뽑고, 그 뼈대 위에 언어모델(구글 젬마 계열)이 한국어 서사, 즉 이 사람이 어떤 사람인지를 입힌다. 인구 분포는 통계청 자료를, 이름 분포는 대법원 자료를 근거로 삼았다. 라이선스도 열려 있어서(CC BY 4.0) 출처만 밝히면 쓸 수 있다.
우리가 여기서 얻은 건 두 가지다. 하나는 규모 — 3만에서 100만으로. 각 인물마다 직업·가족·여행처럼 결이 다른 7가지 변형까지 있어 실질 규모는 더 크다. 다른 하나는 지역 해상도다. Nemotron은 전국을 시·군·구 단위(약 252개)까지 나눠 분포를 맞췄기 때문에, 「부산 해운대구 40대」처럼 좁혀도 그 지역 인구 구성에 맞는 사람들이 나온다. 광역시 뭉뚱그리기가 아니라 동네 단위로 좁혀진다.
정리하면, Nemotron이 통계에 맞는 인구 뼈대를 주고, 네오페르소나가 그 위에 성격과 가치관의 살을 붙인다. 통계 정합성은 남의 잘 만든 데이터에서 빌리고, 우리는 답을 흩어지게 만드는 심리 깊이를 얹는 구조다. 나는 재미삼아 4천만명을 생성해서 따로 보유하고 가끔 이것저것 물어보는데 사용하고 있다.
지금 산업에서 벌어지는 일
그런데 이 재미있는걸 우리만 하는 게 아니다. 지난 2년 사이에 「합성 응답자(synthetic respondents)」라는 이름으로 이 판이 통째로 만들어지고 있다. 뒤섞여 보이지만 사실 세 갈래다.
| 방식 | 무엇을 하나 | 예 |
|---|---|---|
| 순수 합성 | 실제 사람 없이 AI가 답을 지어낸다 | Synthetic Users, Aaru |
| 통계 증강 | 실제로 받은 소량의 응답을 통계로 부풀린다 | Fairgen |
| AI 진행자 | AI가 진짜 사람을 대규모로 인터뷰한다 (합성 아님) | Outset, Genway |
같단하게는 순수 합성 쪽이다. 여기에 돈이 몰린다. Synthetic Users는 참가자 채용 대신 AI 참가자로 사용자 인터뷰를 돌린다. 다만 독립 리뷰(MeasuringU)는 합성 응답이 실제 태도의 큰 방향은 따라가도 심층 행동과는 편차가 크다고 평가했다. Aaru는 수천 개 AI 에이전트로 유권자·소비자 집단을 시뮬레이션하는데, 2025년 12월 시리즈 A에서 「헤드라인 밸류에이션」 10억 달러로 평가받았다. 단, 화려한 값이 정확도를 보증하진 않는다 — 이 회사는 2024년 미국 대선을 해리스 승리(53-47)로 예측했고, 실제로는 트럼프가 이겼다.
큰 조사회사들도 뛰어들었다. 퀄트릭스(Qualtrics)는 2025년 3월 합성 패널 제품(Edge Audiences)을 냈고, NIQ(옛 닐슨)는 2025년 4월 자사 패널 데이터로 신제품 아이디어를 거르는 합성 응답자 도구(BASES AI Screener)를 내놨다. 톨루나(Toluna)는 7,900만 명 자사 패널의 익명 데이터로 만든 합성 페르소나 100만 명 이상을 선보였다. 유고브(YouGov)는 2024년 8월 아예 합성 리서치 회사(Yabble)를 사들였다.
두 번째 줄인 통계 증강은 성격이 좀 다른데, 여기 적어 두는 이유가 있다. Fairgen 같은 곳은 없는 답을 지어내지 않는다. 실제로 받은 응답이 있는데 특정 소집단 표본이 모자랄 때, 그 실제 데이터만으로 학습해 표본을 통계로 늘린다. 그래서 「진짜 데이터로 검증」이 가능하고, 구글·로레알을 비롯한 다섯 건의 제3자 검증 결과가 나와 있다. 순수 합성과 통계 증강의 이 차이가 뒤에서 다시 중요해진다.
종래 서베이 산업이 겁내는 것 — 자기잠식
여기서 이야기가 재밌어진다. 큰 조사회사들이 이걸 반기면서 동시에 겁낸다.
겁내는 이유는 단순하다. 자기 밥그릇을 자기가 깬다는 것이다. 설문조사 회사의 본업은 사람에게 물어서 돈을 받는 것이다. 그런데 합성 응답자가 그 일의 상당 부분을 몇 분에, 몇 분의 일 비용으로 해치우면, 팔던 걸 스스로 싸구려로 만드는 셈이 된다. 이걸 자기잠식(cannibalization)이라고 한다. 그래서 업계 반응이 두 겹으로 갈린다.
겉으로는 거의 모두가 「대체가 아니라 보완」이라고 말한다. 패널 사업을 하는 Cint의 CEO 패트릭 코머는 「우리의 토대는 매일 패널에서 함께 일하는 사람들이며, 그건 사라지지 않는다(Our foundation is the people that we all work with every day in panels: that's not going away)」고 못박는다. 입소스(Ipsos)는 백서에서 검증 안 된 신생 업체들을 대놓고 「엉터리 약장수(snake oil salesmen)」라 부르며 이렇게 적었다 — 「이 기술은 마법이 아니다. 수학이다(this technology is not magic – it is math).」 그리고 합성 데이터의 품질은 「전적으로 실제 인간 데이터에 달려 있다」고 강조한다. 칸타(Kantar)는 일찍이 GPT-4로 자체 실험을 해 보고, 지금의 합성 표본은 「사람 표본을 보완하는 용도로도 아직 충분하지 않다(just not good enough to use as a supplement for human sample)」고 결론 냈다. GPT-4가 지나치게 긍정적으로 답하고, 반복시키니 판에 박힌 답만 나오며 분산과 뉘앙스가 부족하더라는 것이다.
그런데 속을 보면 이야기가 다르다. 퀄트릭스가 14개국 3,000명 넘는 연구자에게 물어본 조사(2025 Market Research Trends Report)에서, 열에 일곱(71%)이 3년 안에 합성 응답이 데이터 수집의 절반 이상을 차지할 거라고 답했다. 「보완일 뿐」이라는 공식 입장과, 정작 그 절반 이상을 합성에 내줄 거라는 전망 사이에 이만큼 간극이 있다. 업계 매체 그린북(GreenBook)은 아예 「설문의 죽음?(The Death of the Survey?)」이라는 제목의 글을 실었다. 다만 그 글에 인용된 마케팅 학자 마크 릿슨(Mark Ritson)은 오히려 회의적인 쪽이다 — 어떤 합성 응답자든 결국 사람이 만든 데이터에 기대고 있다는 것이다.
큰 회사들의 진짜 속내는 「막을 수 없으니 삼키자」에 가깝다. 완전 합성은 위험하다고 거리를 두면서, 자기가 가진 진짜 데이터를 해자(垓字) 삼아 그 위에서 합성을 판다. 유고브가 합성 회사를 사들이고, 톨루나와 NIQ가 자기 패널 데이터로 합성 페르소나를 만드는 게 그 방향이다.
어디서 틀리나
이 연재의 규칙상 이 절이 제일 길어야 한다. 합성 응답자는 그럴듯해서 틀려도 티가 잘 안 난다. 사진과 달리 눈으로 바로 판정할 수 없다. 그래서 어디서 틀리는지를 아는 게 이 물건을 쓰는 자격에 가깝다. 다행히 이건 학자들이 꽤 파 놓았다.
첫째, 답이 가운데로 몰린다. 정치학자들이 ANES라는 유명한 여론조사 데이터로 시험해 봤더니(Bisbee 외, 2024), 합성 응답은 분산이 부족했다. 답이 평균 근처에 과도하게 모여서 집단 간 차이가 무너지고, 그런데 겉보기 정밀도는 오히려 진짜보다 높아 보인다. 이게 함정이다. 정밀해 보이니까 실제로 필요한 표본 수를 과소평가하게 된다. 없는 확신을 만들어 내는 것이다. 앞에서 「성격을 박아서 답을 흩어지게 만든다」고 했는데, 그렇게 해도 진짜 사람만큼은 안 흩어진다.
둘째, 다수에 쏠리고 소수를 지운다. 언어모델은 학습 데이터에서 자주 본 쪽으로 답을 끈다. 여러 연구가 합성 응답이 남성·고학력 쪽으로 기울고 소수 집단의 의견을 과소 대표한다고 지적한다(Santurkar 외, 2023 등). 시장조사에서 가장 값나가는 정보가 종종 「소수가 강하게 싫어한다」는 신호인데, 그게 바로 뭉개지는 자리다.
셋째, 같은 질문에 다른 답을 한다. 같은 정치학자들이 똑같은 프롬프트를 석 달에 걸쳐 다시 돌렸더니, 회귀계수의 절반 가까이(48%)가 실제 데이터와 유의하게 어긋났고, 그렇게 어긋난 계수 가운데 3분의 1(32%)은 아예 부호가 반대로 뒤집혔다. 좋아한다던 게 싫어한다로 바뀌는 것이다. 재현이 안 되면 그건 조사가 아니다.
넷째, 자기가 자기를 갉아먹는다 — 더 깊은 자기잠식. 앞의 자기잠식이 사업 이야기였다면 이건 기술 이야기다. 2024년 네이처(Nature)에 실린 연구(Shumailov 외)는, AI가 만든 데이터로 AI를 다시 학습시키기를 반복하면 모델이 무너진다는 걸 보였다. 세대를 거듭할수록 분포의 꼬리 — 즉 드물고 극단적인 케이스 — 부터 먼저 사라진다. 합성 응답을 다시 학습에 쓰고, 그 모델로 또 합성 응답을 만드는 순환이 돌면, 구조적으로 소수 의견이 지워진다. 둘째 문제(소수 지우기)가 시간이 갈수록 저절로 심해지는 셈이다.
그럼 희망적인 연구는 없나. 있다. 스탠퍼드 연구진(Park 외, 2024)이 실제 미국인 1,052명을 한 명당 두 시간씩 인터뷰해서 그 사람을 흉내 내는 에이전트를 만들었더니, 그 에이전트가 원본과 상당히 비슷하게 답했다(정규화 정확도 약 0.85). 흔히 「85% 정확」으로 인용되는 숫자다. 단, 두 가지를 봐야 한다. 하나, 그 0.85는 완벽(1.0)이 「본인이 2주 뒤에 다시 답한 것」을 기준으로 한 값이다. 사람도 2주 뒤엔 자기랑 완전히 같게 답하지 않는다. 둘, 이 정확도를 얻으려면 한 명당 두 시간짜리 진짜 인터뷰가 필요했다. 겉 속성만으로 지어낸 페르소나만 쓰면 정확도가 뚝 떨어진다. 즉 진짜 데이터를 얼마나 먹였느냐가 전부다. 입소스가 「수학이지 마법이 아니다」라고 한 게 이 지점이다.
그래서 어디에 쓰나
틀리는 자리를 늘어놓았다고 쓸모없다는 건 아니다. 쓰는 자리가 정해져 있다. 가르는 기준은 딱 하나 — 그 결정이 틀렸을 때 얼마나 되돌리기 어려운가.
| 써도 되는 곳 (저위험·앞단) | 쓰면 안 되는 곳 (고위험·비가역) |
|---|---|
| 설문지를 실제로 돌리기 전 사전 점검 | 가격·출시 여부 같은 돈이 걸린 결정 |
| 콘셉트 스무 개 중 어느 걸 남길지 추리기 | 의료·금융 같은 규제 산업 |
| 가설 만들기, 방향 잡기 | 직접 겪은 경험·감정의 깊이가 핵심인 조사 |
| 임원·전문가처럼 만나기 어려운 집단 흉내 | 학습 데이터에 없는 진짜 새로운 것 |
핵심은 합성으로 좁히고 진짜로 확인한다는 순서다. 합성 응답자로 가설을 세우고 후보를 스무 개에서 세 개로 줄인 다음, 그 셋만 진짜 사람에게 물어 확정한다. 업계에서 자리 잡아 가는 방식이 이거다.
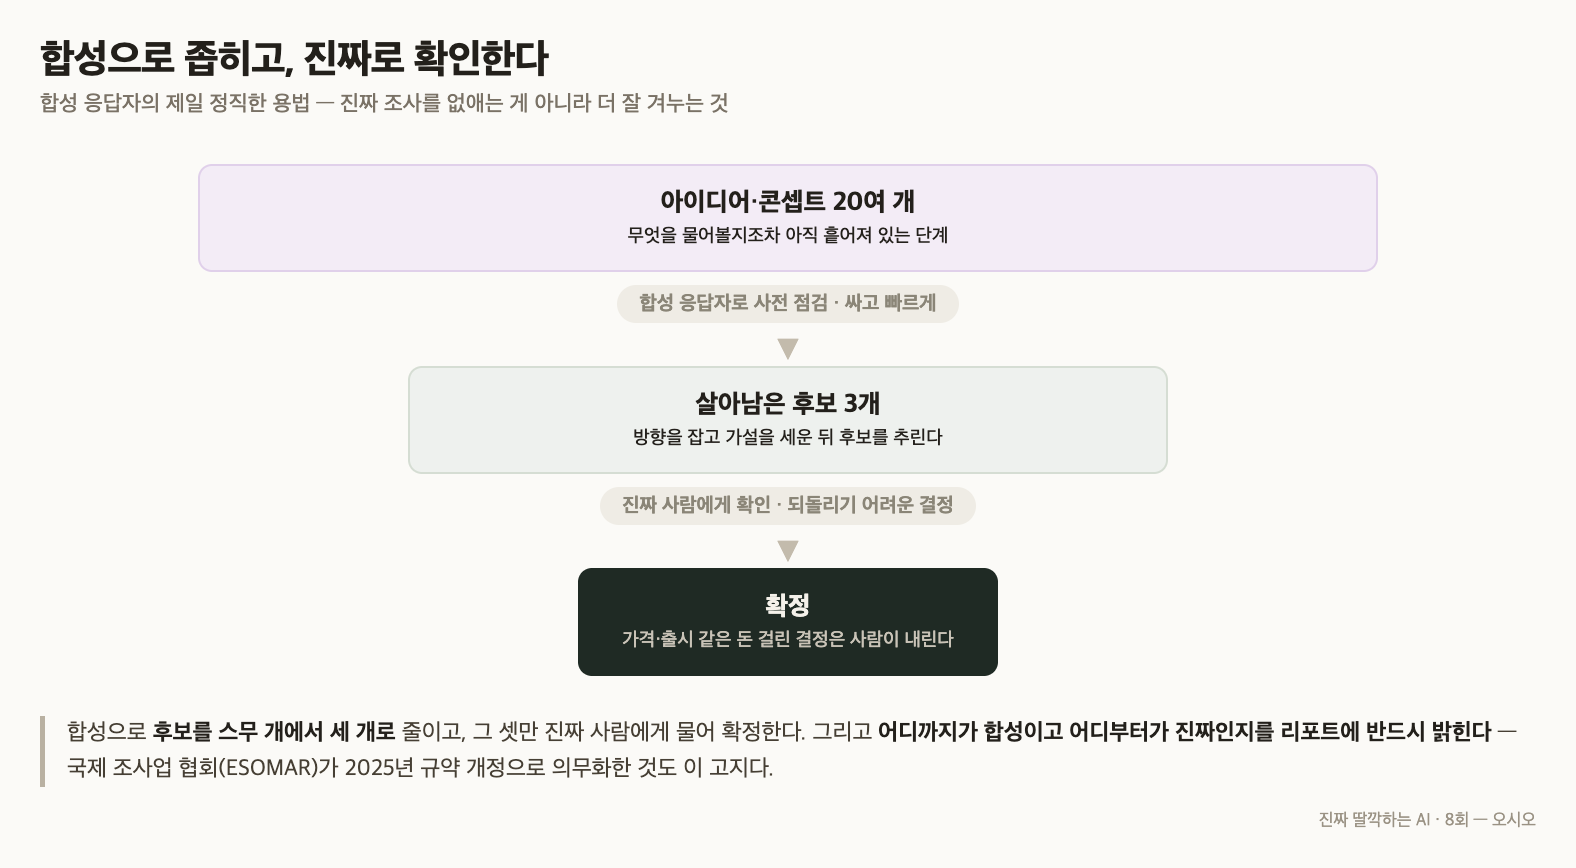
그리고 하나 더, 어디까지가 합성이고 어디부터가 진짜인지를 리포트에 반드시 밝히는 것. 실제로 국제 조사업 규약(ICC/ESOMAR)은 2025년 개정에서, 합성 데이터를 쓴 경우 그 방법과 데이터 출처, 한계를 고객에게 고지하도록 요구하는 조항을 새로 넣었다. 합성을 진짜 사람인 척 흐리지 말라는 것이다.
못 하는 것
진짜 새로운 것에 대한 반응은 못 만든다. 합성 응답자는 학습 데이터에서 본 세상을 되비추는 물건이다. 세상에 없던 콘셉트에 사람들이 어떻게 반응할지는, 정의상 학습 데이터에 없다. 「전에 이런 거 나왔을 때 사람들 반응」을 잘 흉내 낼 뿐이다.
직접 겪은 이야기를 대신하지 못한다. 아파 본 사람, 큰 손해를 본 사람, 차별을 겪은 사람의 말에는 지어낼 수 없는 구체가 있다. 합성은 그 자리에서 평균적인 문장을 만들 뿐이다.
틀린 걸 즉시 알 수 없다. 앞선 회차의 사진·영상 작업은 틀리면 눈에 보였다. 합성 응답은 반대다. 그럴듯한 표와 그래프가 나오기 때문에, 틀렸는지 확인하려면 결국 진짜 데이터와 대 봐야 한다. 그래서 이 물건의 제일 정직한 용법은 「진짜 조사를 없애는 도구」가 아니라 「진짜 조사를 더 잘 겨누게 하는 도구」다.
우리가 3만 명을 만들고 100만 명분 재료를 얹은 것도 그래서다. 사람을 대신하려는 게 아니라, 사람에게 무엇을 물어야 할지를 먼저 싸게 알아보려는 것. 딸깍으로 답을 얻되, 그 답을 믿을 자리와 믿지 말 자리를 아는 것까지가 이번 일이었다.
사실 글에 밝히지는 못하겠지만 이보다 더 깊고 재미있는 개선도 많이 포함해서 직므은 제법 그럴싸한 문제 해결에도 응용하고 있다. 참 흥미로운 일이라고 생각한다.
출처와 더 읽을거리
숫자와 인용은 모두 아래 1차 자료에서 확인했다. 회사가 자사 제품에 대해 내세우는 정확도는 대개 자체 발표라, 이 글에는 검증 가능한 것만 실었다.
데이터셋
- NVIDIA, Nemotron-Personas-Korea (Hugging Face, 2026) — huggingface.co/datasets/nvidia/Nemotron-Personas-Korea
논문
- Argyle 외, "Out of One, Many: Using Language Models to Simulate Human Samples," Political Analysis 31(3), 2023 — doi.org/10.1017/pan.2023.2
- Park 외, "Generative Agent Simulations of 1,000 People," 2024 — arxiv.org/abs/2411.10109
- Bisbee 외, "Synthetic Replacements for Human Survey Data? The Perils of Large Language Models," Political Analysis 32(4), 2024 — doi.org/10.1017/pan.2024.5
- Shumailov 외, "AI models collapse when trained on recursively generated data," Nature 631, 2024 — doi.org/10.1038/s41586-024-07566-y
- Santurkar 외, "Whose Opinions Do Language Models Reflect?" 2023 — arxiv.org/abs/2303.17548
기업·기관
- Qualtrics, "Synthetic data in market research" — qualtrics.com · 2025 Market Research Trends Report — prnewswire.com
- Ipsos, Synthetic Data: From Hype to Reality — ipsos.com (PDF)
- Kantar, "What is synthetic sample – and is it all it's cracked up to be?" (2023) — kantar.com
- Cint, "Why everything we thought we knew about sampling might change" — cint.com
- YouGov, "YouGov acquires Yabble" (2024) — yougov.com
- NielsenIQ, "BASES AI Screener" (2025) — nielseniq.com
- Toluna, "One million synthetic personas" (2025) — tolunacorporate.com
- ICC/ESOMAR International Code — iccwbo.org
스타트업·업계 매체
- Fairgen, Google 합성 데이터 검증 연구 — fairgen.ai
- Synthetic Users, 독립 리뷰 (MeasuringU) — measuringu.com
- Aaru, "헤드라인 밸류에이션" 시리즈 A (TechCrunch, 2025) — techcrunch.com · 2024 대선 예측 (Semafor, 2024) — semafor.com
- GreenBook, "The Death of the Survey?" — greenbook.org