AI 유권자 5천 명에게 투표를 시킨 사람들 — 선거를 미리 돌려보는 합성 유권자
사람 대신 AI가 만든 가상 유권자에게 표를 묻는 회사와 연구가 늘고 있다. 뉴욕 예비선거를 371표 차로 맞히고 대선은 빗나간 Aaru, 독일어로 물었더니 녹색당으로 기운 GPT, 한국 지방선거를 예측해 본 국내 업체까지 따라가 보고, 네오페르소나로 직접 돌려 본 소감과 이걸 여론조사라고 부르면 안 되는 이유를 적었다.
선거철이 되면 여론조사가 쏟아진다. 누가 몇 %p 앞선다는 숫자가 매일 바뀌고, 조사 회사마다 결과가 조금씩 다르다. 그 숫자 하나를 얻으려고 조사원들은 수천 통의 전화를 돌린다. 요즘은 전화를 받는 사람도 드물다.
그런데 몇 년 전부터 전혀 다른 방식으로 표심을 재 보려는 사람들이 나타났다. 사람에게 묻지 않고, AI가 만든 가상의 유권자에게 묻는 것이다. 나이·지역·직업·성향을 실제 인구 구성에 맞춘 가짜 사람 수천 명을 만들어 놓고, 후보와 쟁점을 보여 준 다음 누구를 찍겠느냐고 묻는다. 전화 한 통 걸지 않고 몇 분 만에 결과가 나온다.
지난 8회에서 이 방식으로 소비자 조사를 하는 이야기를 했다. 이번에는 같은 도구를 선거에 들이댄 사람들 이야기다. 신제품 요거트는 틀려도 다시 만들면 되지만, 선거는 한 번뿐이고 틀리면 곤란한 사람이 많다. 그래서 훨씬 재미있고, 훨씬 조심스럽다.
논문 한 편에서 시작됐다
출발점은 2023년 미국 정치학 학술지 『Political Analysis』에 실린 논문 한 편이다. 브리검영대 연구진(Argyle 외)은 제목부터 도발적으로 「하나에서 여럿으로(Out of One, Many)」라고 붙였다.
방법은 이렇다. 미국에서 가장 권위 있는 선거 조사인 ANES의 실제 응답자 수천 명의 배경, 곧 나이·성별·인종·학력·정당 성향·종교 같은 것을 문장으로 풀어 GPT-3에 넣는다. 「나는 조지아에 사는 50대 백인 남성이고, 교회에 자주 나가며, 스스로 보수적이라고 생각한다」 같은 식이다. 그리고 이 사람이라면 대선에서 누구를 찍었겠느냐고 묻는다. 연구진은 이렇게 만든 가상 응답자 집단을 실리콘 표본(silicon sample)이라고 불렀다.
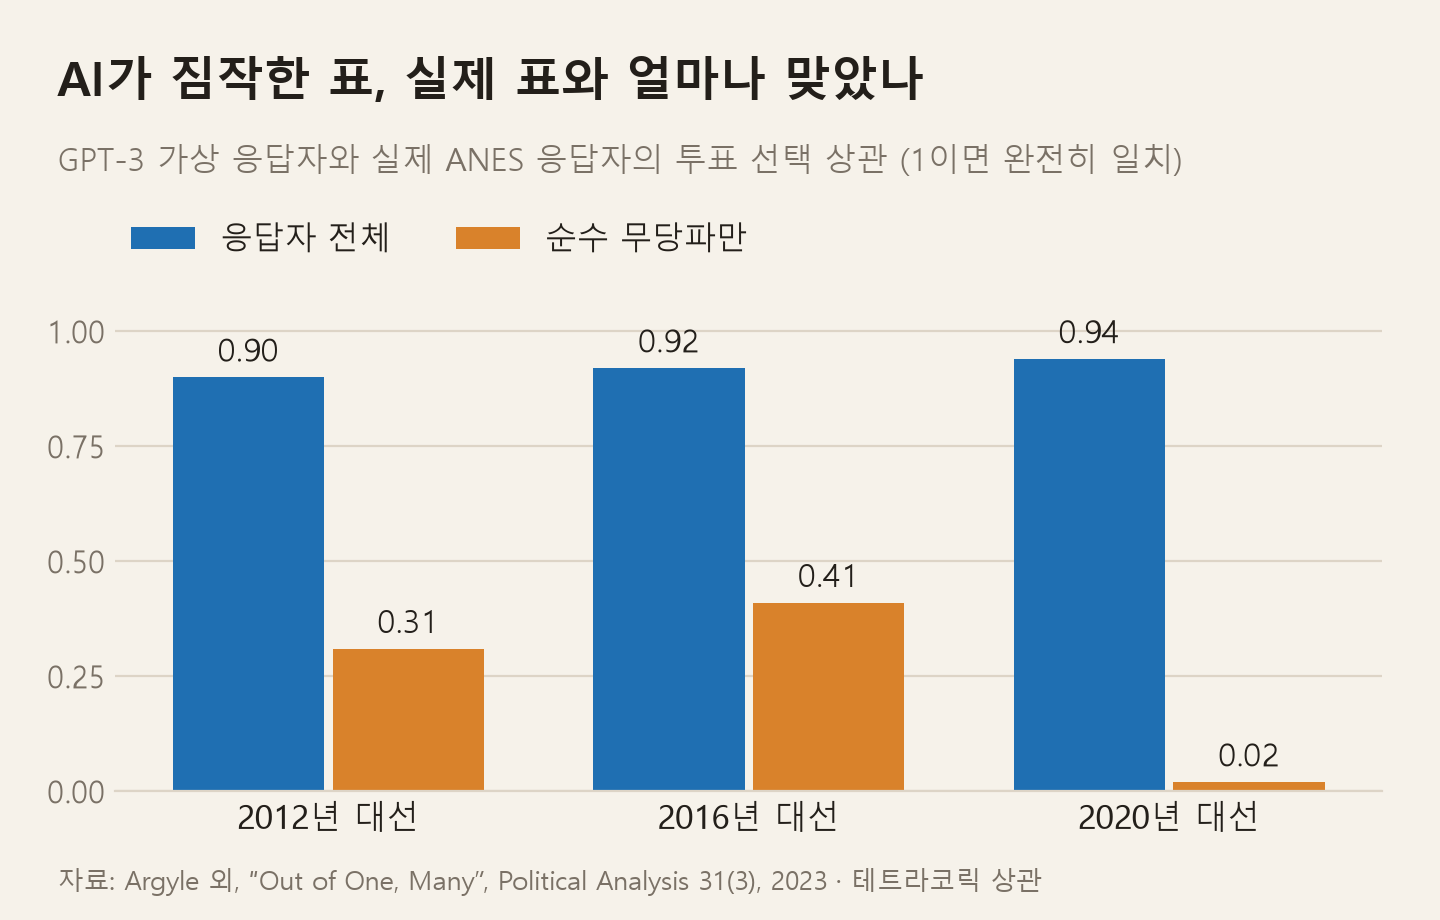
결과는 놀라웠다. AI가 답한 투표 선택과 실제 사람의 투표 선택 사이의 상관이 2012년 대선 0.90, 2016년 0.92, 2020년 0.94까지 나왔다. 배경만 알려 줬을 뿐인데, 언어모델이 그 사람의 표를 꽤 그럴듯하게 짐작해 낸 것이다.
다만 부록을 들여다보면 구멍이 하나 보인다. 어느 정당에도 기울지 않은 순수 무당파만 따로 떼어 보면 상관이 2012년 0.31, 2020년에는 0.02까지 떨어진다. 사실상 맞히지 못했다는 뜻이다. 공화당원이 공화당을 찍는 걸 맞히는 건 어렵지 않다. 선거를 가르는 건 늘 그 가운데 사람들인데, AI가 제일 못 맞히는 자리가 바로 거기였다.
표를 파는 회사들
논문이 나오자 곧바로 회사가 따라왔다. 가장 유명한 곳이 뉴욕의 스타트업 Aaru다.
2024년 9월, 미국 매체 세마포(Semafor)는 Aaru가 그해 6월 뉴욕 민주당 하원 예비선거 결과를 실제 득표와 371표 차이로 맞혔다고 보도했다. 사람 대신 AI 응답자 약 5천 명을 썼고, 조사 한 번에 1분 남짓, 비용은 사람 조사의 10분의 1도 안 든다는 게 회사 설명이었다. 공교롭게도 5천 명이다.
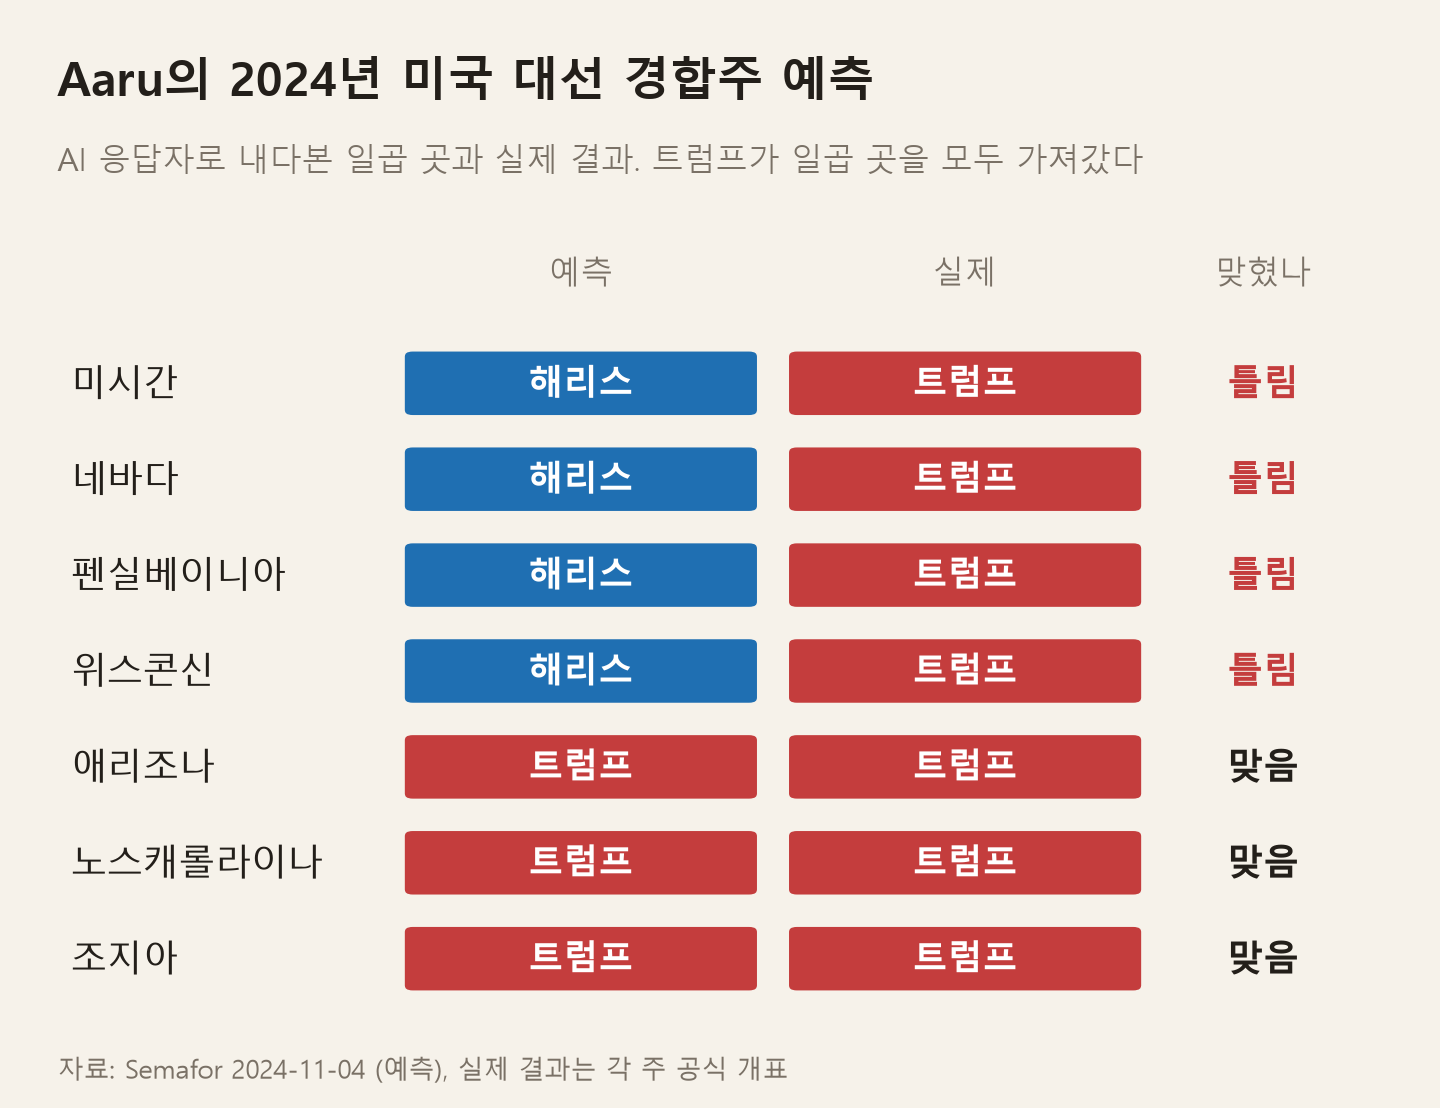
그리고 두 달 뒤 대선이 왔다. Aaru는 경합주 일곱 곳 가운데 미시간·네바다·펜실베이니아·위스콘신을 해리스 우세로 내다봤다. 결과는 모두가 아는 대로다. 트럼프가 일곱 곳을 전부 가져갔다. 선거 이튿날 공동창업자는 이렇게 말했다. 「동전 던지기는 동전 던지기다. 53 대 47은 48 대 52와 통계적으로 크게 다르지 않다. 우리는 오차범위 안에 있었으니 잘한 셈이다.」
틀렸다고 끝난 건 아니다. Aaru는 2025년 12월 시리즈 A에서 일부 지분을 10억 달러 가치로 받았다(테크크런치 보도). 고객 명단에는 액센추어, EY 같은 이름과 함께 정치 캠페인이 올라 있다. EY와 함께 한 작업에서는 30여 개 시장 투자자 3,600명을 대상으로 6개월 걸리던 설문을 하루 만에 시뮬레이션해, 실제 응답과의 순위 상관 중앙값 0.90을 얻었다고 공개했다.
비슷한 회사가 줄줄이 있다.
| 회사 | 어디서 | 무엇을 하나 |
|---|---|---|
| Aaru | 미국 | AI 응답자로 선거·시장 예측. 정치 캠페인이 고객 |
| Simile | 미국 | 개인 단위 디지털 트윈. 미국인 1천 명을 두 시간씩 인터뷰해 그 사람을 흉내 내는 AI를 만든 스탠퍼드 연구진이 세웠고, 2026년 2월 1억 달러 유치 |
| Electric Twin | 영국 | 실제 설문과 언어모델을 섞은 「합성 청중」. 창업자가 전 영국 총리실 데이터 자문 |
| Expected Parrot | 미국 | AI 에이전트로 설문·실험을 돌리는 오픈소스 도구. MIT 경제학자가 세움 |
선거만 하는 곳은 드물다. 대부분 기업 고객에게 「우리 광고를 사람들이 어떻게 볼까」를 파는 게 본업이고, 선거는 가장 눈에 띄는 쇼케이스다. 선거는 몇 달 뒤 정답이 공개되는 몇 안 되는 시험장이기 때문이다. 맞히면 광고가 되고, 틀리면 위의 인터뷰처럼 해명을 해야 한다.
미국 선거 캠프 쪽에서는 이미 합성 유권자로 포커스그룹을 돌린다는 이야기가 공공연하다. 올해 8월 테크폴리시프레스(TechPolicy.Press)는 「합성 유권자가 온다(Here Come the Synthetic Voters)」라는 기사에서, 캠프들이 연설문이나 광고 문구를 사람에게 보이기 전에 가상 유권자에게 먼저 돌려 보는 흐름과 그 위험을 다뤘다.
한국어로 물으면
여기까지는 전부 미국 이야기다. 미국 선거는 양당 구도가 선명하고, 인터넷에 영어 글이 넘쳐나며, 언어모델은 그 글을 먹고 자랐다. 다른 나라에서도 통할까.
독일 연구진(von der Heyde 외)이 이걸 시험했다. 2017년 독일 연방선거 조사 응답자와 같은 배경의 가상 인물을 만들어, GPT-3.5에게 독일어로 투표 선택을 물었다. 결과는 한마디로 「못 맞힌다」였다. 특히 녹색당과 좌파당 쪽으로 쏠렸다. 연구진은 인터넷 글 가운데 독일어는 5%도 안 되고 영어는 절반이 넘는다는 점을 짚었다. 같은 연구진이 2024년 유럽의회 선거로 범위를 넓혀 유권자 2만 6천 명의 배경으로 다시 해 봤을 때도 결론은 비슷했다. 예측은 대체로 실패했고, 그 정확도마저 나라와 언어에 따라 들쭉날쭉했다.
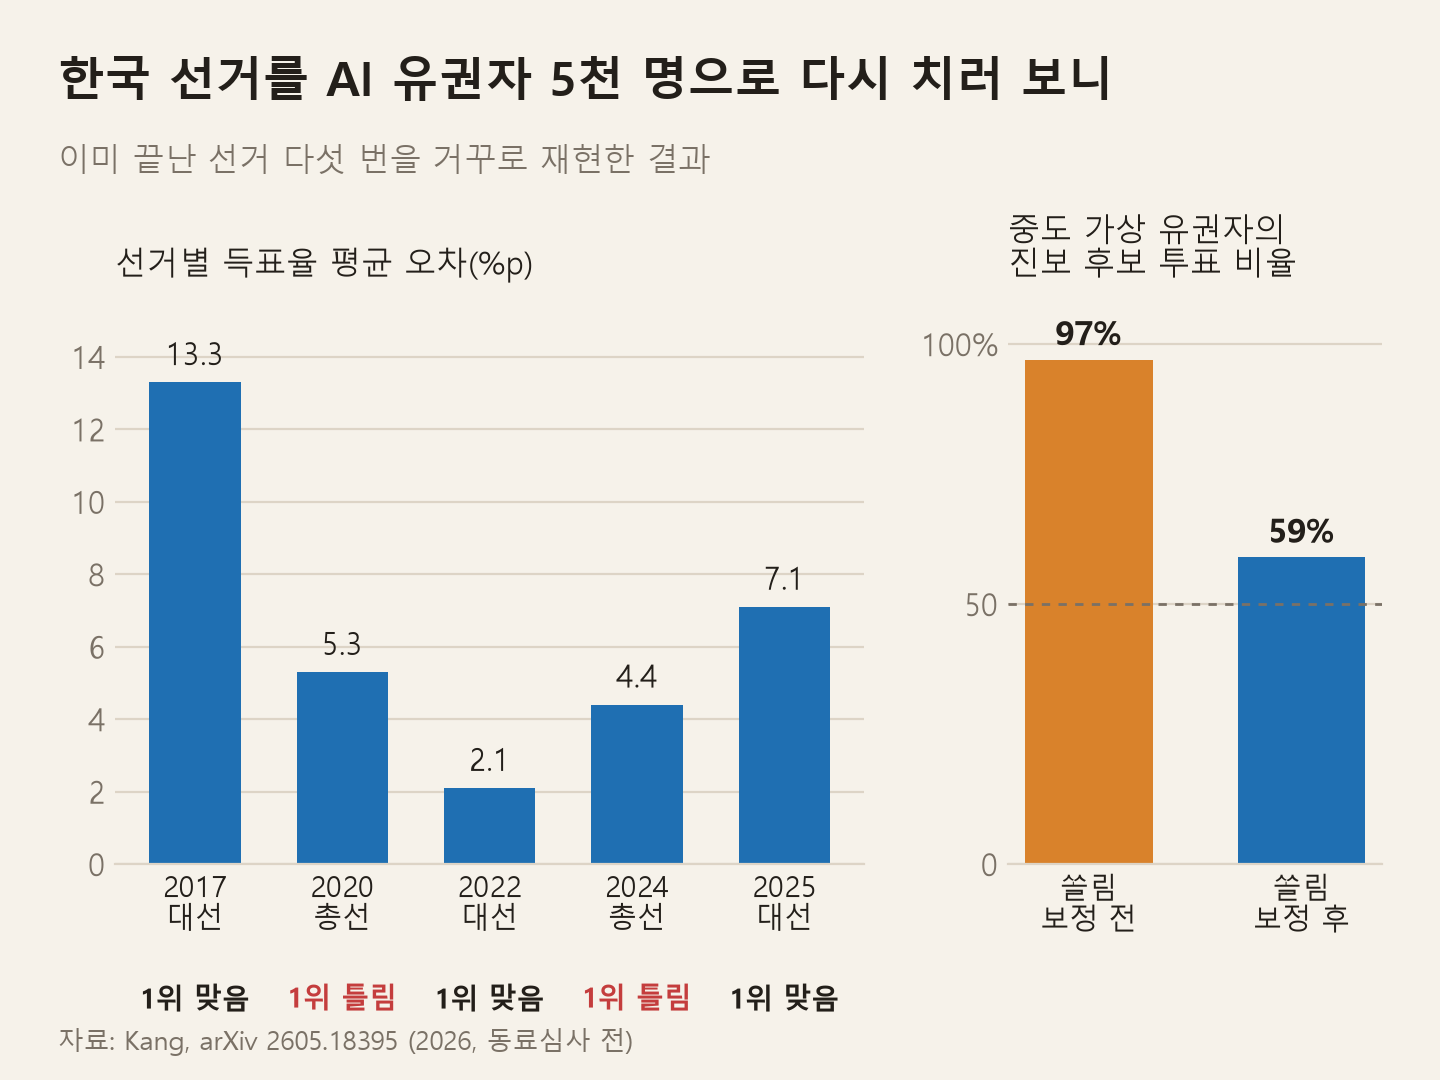
한국은 어떨까. 올해 5월 고려대 연구자가 올린 논문(Dynamo-K, 동료심사 전)이 거의 유일하게 이 질문을 정면으로 다뤘다. 국내 사회조사 자료로 가상 유권자 5천 명을 만들고, 언어모델 넷에게 한국어로 2017년부터 2025년까지 한국 선거를 다시 치르게 했다. 여기서도 5천 명이다. 대선 당선자는 세 번 다 맞혔고, 0.73%p 차이로 갈린 2022년 대선도 평균 오차 2.1%p로 따라갔다. 반면 총선 두 번은 모두 제1당을 틀렸다. 그런데 그 결과를 얻으려면 한 가지를 먼저 손봐야 했다. 모델을 그대로 두면 가상 유권자들이 진보 쪽으로 기울었다. 보정하기 전에는 중도 성향 가상 유권자의 97%가 진보 후보를 찍었다. 이 쏠림을 명시적으로 바로잡자 그 비율이 59%로 내려왔고, 평균 오차는 5분의 1로 줄었다. 독일에서 녹색당으로 기울던 것과 같은 병이다. 한 가지 더 기억할 점은, 이 연구도 이미 결과가 나온 선거를 거꾸로 재현한 것이지 미리 맞힌 게 아니라는 것이다.
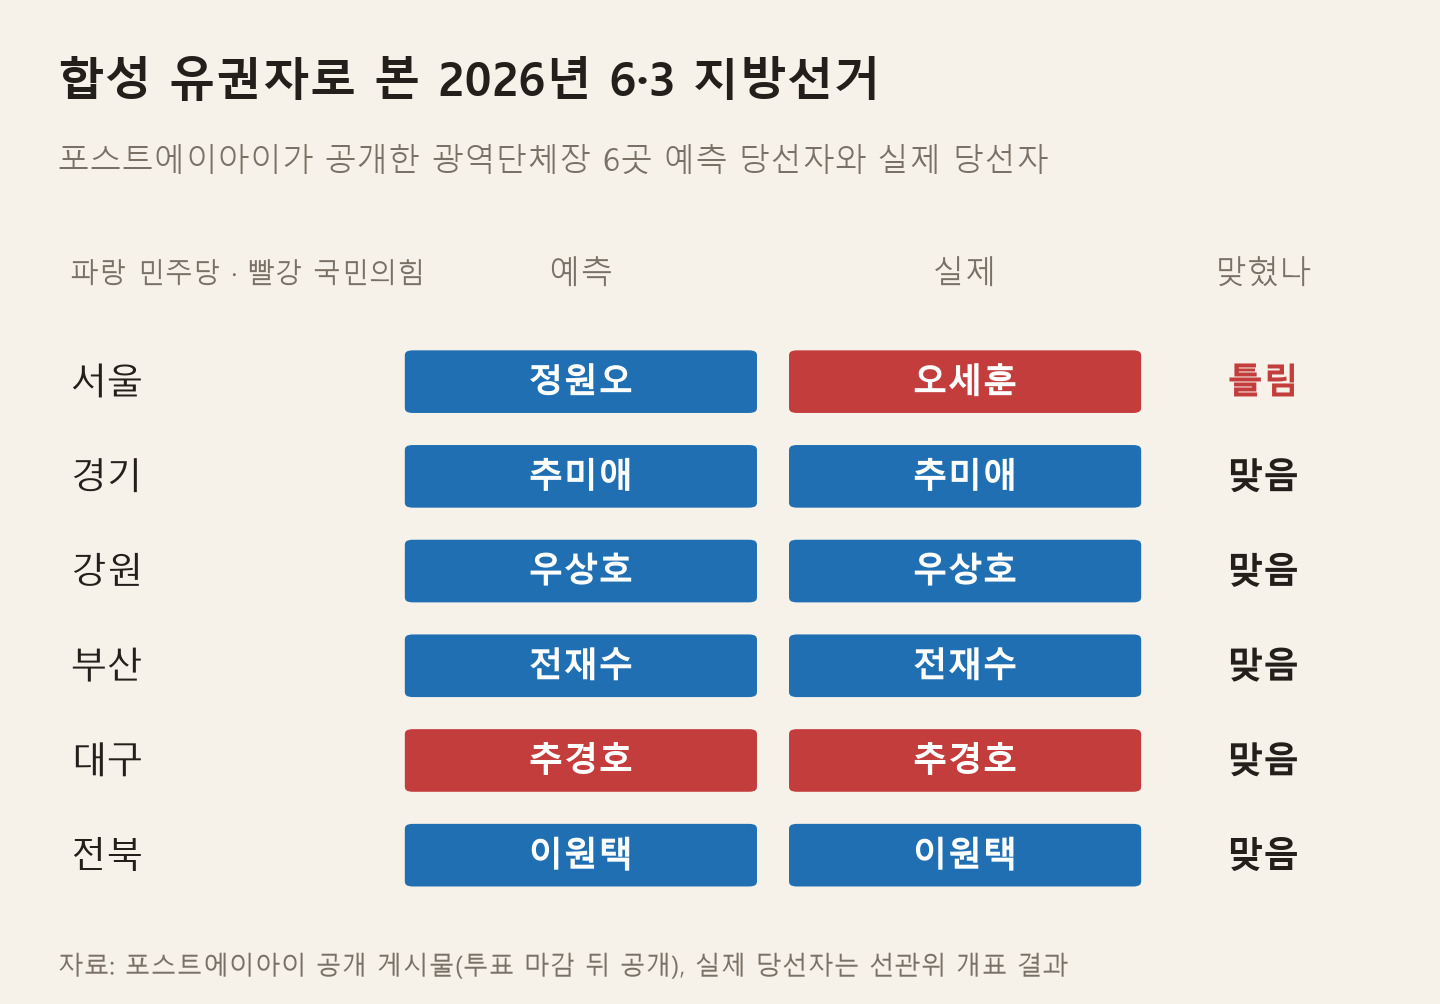
미리 맞혀 본 곳도 있다. 국내 AI 업체 포스트에이아이는 올해 6월 3일 지방선거 날, 자사의 합성 유권자로 광역단체장 여섯 곳을 예측한 결과를 투표 마감 뒤 공개했다. 「출구조사나 여론조사가 아니라 AI 페르소나 기반 시뮬레이션」이라고 분명히 밝혔다. 여섯 곳 가운데 다섯 곳의 당선자를 맞혔고, 서울은 틀렸다.
어디서 틀리나
사례를 나란히 놓으면 틀리는 자리가 거의 같다.
답이 가운데로 몰린다. 미국 정치학자들(Bisbee 외, 2024)이 ChatGPT에 같은 실험을 해 보니, 평균은 실제 조사와 비슷했지만 응답의 퍼짐이 훨씬 좁았다. 실제 사람들은 같은 조건에서도 제각각 답하는데, 가상 유권자들은 서로 비슷하게 답한다. 그래서 결과가 실제보다 정밀해 보인다. 없는 확신이 생기는 것이다.
같은 질문을 다시 하면 다른 답이 나온다. 같은 연구에서 똑같은 질문을 2023년 4월, 6월, 7월에 다시 돌렸더니 분포가 달라졌다. 모델이 조용히 업데이트되기 때문이다. 지난달의 결과와 이번 달의 결과를 비교해 「민심이 움직였다」고 말할 수가 없다. 움직인 게 민심인지 모델인지 모르니까.
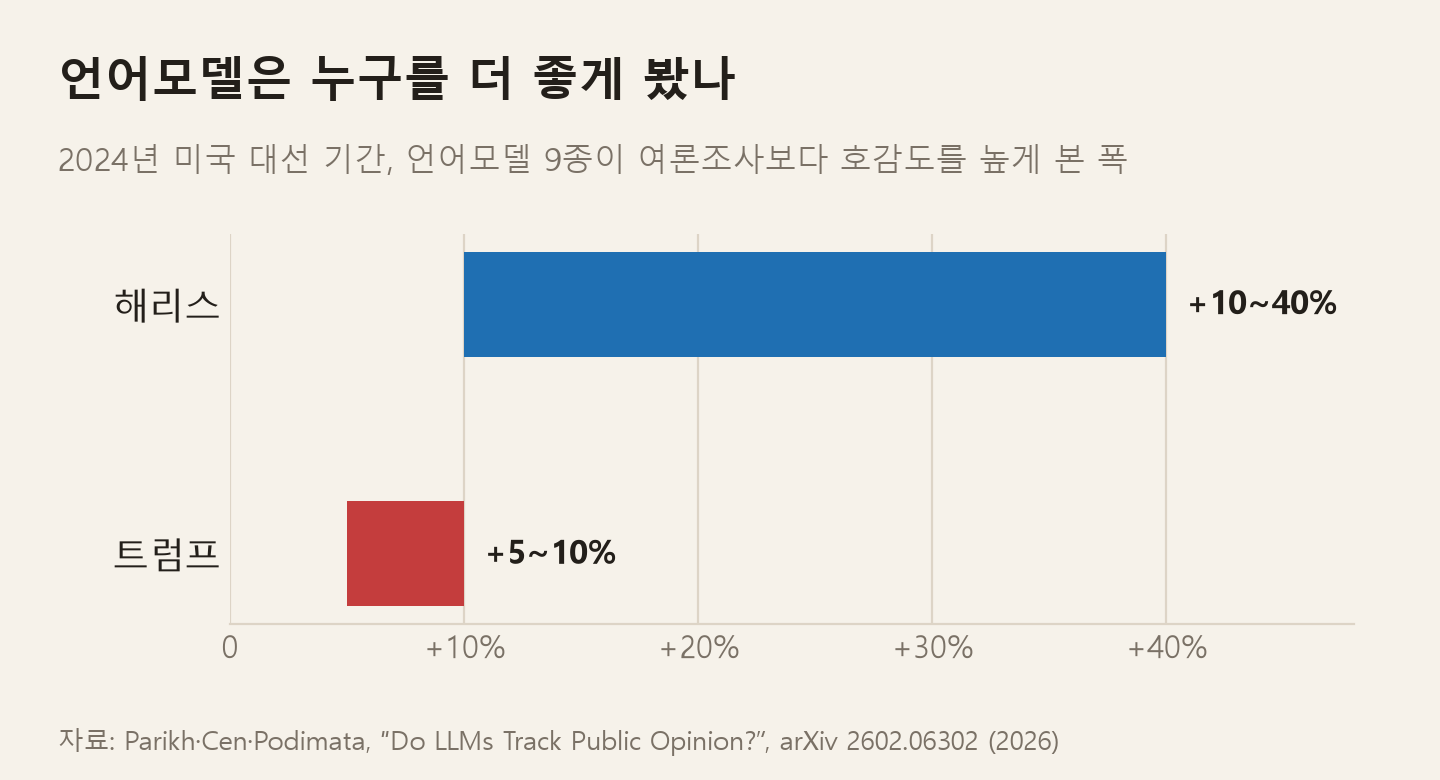
특정 쪽으로 기운다. 올해 2월 나온 연구(Parikh 외)는 2024년 미국 대선 기간 동안 여러 언어모델의 답을 실제 여론조사와 나란히 놓았다. 모든 모델이 해리스의 호감도를 여론조사보다 10~40% 높게 봤다. 트럼프도 높게 보긴 했지만 5~10% 정도였다.
독일의 녹색당, 한국의 진보 쏠림과 같은 줄기다. 언어모델이 먹고 자란 인터넷 글이 유권자 전체를 고르게 대표하지 않기 때문이다.
맞힌 것처럼 보이기 쉽다. 이미 끝난 선거를 재현하는 건 예측이 아니다. 답을 알고 나면 손잡이를 돌려 맞출 여지가 생긴다. 선거 뒤에 「우리 모델로 돌렸더니 맞았다」는 발표가 나오면, 그게 선거 전에 공개된 것이었는지부터 봐야 한다.
AI는 대신 찍어 주지 않는다
한 가지 재미있는 벽도 있다. 요즘 주요 언어모델에게 실존 후보를 두고 「이 사람이라면 누구를 찍겠느냐」고 계속 물으면, 답을 피하거나 거절하는 경우가 적지 않다.
만든 회사들이 선거를 일부러 조심하도록 가르쳤기 때문이다. 앤트로픽은 2024년 선거를 앞두고 Claude를 정치 캠페인에 쓰지 못하게 했고, 올해 4월에는 사용자가 특정 관점으로 끌려가지 않고 스스로 결론에 이르도록 돕는 것을 선거 관련 답변의 원칙으로 밝혔다. 오픈AI의 모델 명세서도 「모델이 자기 의제를 좇아 사용자를 한쪽으로 몰아가면 안 된다」고 적는다. 가상 유권자의 입을 빌려도 결국 그 표를 고르는 건 모델이라, 이 원칙에 걸리는 셈이다.
선거 시뮬레이션을 하려는 쪽에서 보면 불편한 일이지만, 생각해 보면 당연하다. 수억 명이 쓰는 AI가 특정 후보 쪽으로 조금만 기울어도 그 영향은 어떤 여론조사보다 크다. 앞에서 본 것처럼 모델은 이미 한쪽으로 조금씩 기울어 있다.
나도 돌려 봤다
사실 나도 해 봤다. 8회에서 소개한 네오페르소나, 곧 통계 분포에 맞춰 만든 가상 인물 풀에서 지역별로 유권자를 뽑아, 지난 6월 지방선거를 앞두고 투표를 시켜 봤다.
결과는 제법 재미있었다. 확실한 곳은 확실하게, 박빙인 곳은 박빙으로 갈렸고, 큰 그림은 당시 여론조사의 흐름과 대체로 같은 방향을 가리켰다. 무엇보다 재미있던 건 숫자보다 과정이었다. 앞에서 적은 벽, 그러니까 AI가 실존 후보를 두고 표를 대신 골라 주지 않으려 한다는 걸 직접 부딪쳐 확인했고, 가정 하나를 바꿀 때마다 판이 어떻게 흔들리는지를 몇 분 만에 볼 수 있었다. 「이 지역에서 이 이슈가 크게 번지면 어떻게 되나」 같은 질문을 사람 수천 명 모으지 않고 던져 볼 수 있다는 것 자체가 신기한 경험이었다.
다만 그 결과를 여기 숫자로 적지는 않는다. 이유는 아래에 있다.
여론조사라고 부르면 안 된다
미국여론조사협회(AAPOR)는 올해 6월 윤리강령을 고치면서 이 문제에 선을 그었다. AI가 만들어 낸 응답은 연구 참여자가 아니다. 그리고 「여론조사」나 「설문」이라는 말은 사람에게서 얻은 자료를 뜻하므로, AI가 만든 자료에 그 이름을 붙이면 안 된다. 같은 협회의 태스크포스 보고서는 합성 응답을 쓴 결과에 붙일 공개 문구의 예로 이 문장을 들었다. 「합성 응답으로는 오차범위를 낼 수 없다.」 오차범위는 실제 사람을 무작위로 뽑았을 때만 계산되는 값이기 때문이다.
한국도 이미 기준이 있다. 중앙선거관리위원회는 2023년 8월, 총선을 앞두고 생성형 AI 관련 운용기준을 냈다. 생성형 AI로 지지도나 선거 결과를 예측해 공표하는 것 자체는 AI로 분석한 결과라 신뢰도에 한계가 있을 수 있다는 걸 밝히면 할 수 있다. 하지만 그걸 여론조사 결과로 오인하게 하는 방식으로 내놓으면 공직선거법의 허위논평·보도 금지 조항에 걸릴 수 있다고 못박았다. 앞의 포스트에이아이가 「여론조사가 아니다」라는 문장을 굳이 붙인 이유다.
그래서 이 글에서도 가상 유권자 실험 결과를 「조사」라고 부르지 않았고, 내 실험의 숫자도 싣지 않았다. 퍼져 나가는 순간 「AI 여론조사에서 누가 몇 % 앞섰다」로 읽히기 딱 좋은 숫자이기 때문이다.
그래서 어디에 쓰나
그럼 쓸모가 없느냐 하면, 그렇지 않다. 쓰는 자리가 정해져 있을 뿐이다.
합성 유권자는 예측 도구가 아니라 가정 실험 장치에 가깝다. 「이 쟁점이 커지면」, 「이 후보가 이 공약을 내면」, 「투표율이 이만큼 낮으면」 같은 가정을 넣고 그 가정이 어디로 이어지는지를 싸고 빠르게 훑어본다. 그다음 정말 중요해 보이는 몇 가지만 진짜 사람에게 묻는다. 8회에서 적은 「합성으로 좁히고 진짜로 확인한다」는 순서가 선거에서도 그대로다. 미국 캠프들이 연설문을 가상 유권자에게 먼저 읽히는 것도 결국 이 용도다.
반대로 「AI가 뽑은 당선자」 같은 제목으로 결과를 내놓는 순간, 이 도구는 가장 위험한 자리로 간다. 모델의 쏠림이 민심처럼 포장되고, 오차범위도 없는 숫자가 오차범위 있는 숫자와 나란히 놓인다.
다음 선거철에도 아마 다시 돌려 볼 것 같다. 맞히려고가 아니라, 판이 어떤 가정 위에 서 있는지 보려고.
출처와 더 읽을거리
논문
- Argyle 외, "Out of One, Many: Using Language Models to Simulate Human Samples," Political Analysis 31(3), 2023 — arxiv.org/abs/2209.06899
- Bisbee 외, "Synthetic Replacements for Human Survey Data? The Perils of Large Language Models," Political Analysis 32(4), 2024 — cambridge.org
- von der Heyde·Haensch·Wenz, "Vox Populi, Vox AI? Using Language Models to Estimate German Public Opinion," 2024 — arxiv.org/abs/2407.08563
- von der Heyde 외, "United in Diversity? Contextual Biases in LLM-Based Predictions of the 2024 European Parliament Elections," 2024 — arxiv.org/abs/2409.09045
- Parikh·Cen·Podimata, "Do LLMs Track Public Opinion?" 2026 — arxiv.org/abs/2602.06302
- Kang, "Diagnosing Korean-Language LLM Political Bias via Census-Grounded Agent Simulation," 2026 (동료심사 전) — arxiv.org/abs/2605.18395
기업·보도
- Semafor, Aaru 뉴욕 예비선거 (2024-09-20) — semafor.com · 대선 예측 (2024-11-04) — semafor.com · 선거 뒤 해명 (2024-11-06) — semafor.com
- TechCrunch, Aaru 시리즈 A (2025-12) — techcrunch.com
- EY, AI 시뮬레이션 설문 사례 (2025-10) — ey.com
- SiliconANGLE, Simile 1억 달러 유치 (2026-02-12) — siliconangle.com
- UKTN, Electric Twin 투자 유치 (2026-02-12) — uktech.news
- Expected Parrot — expectedparrot.com
- TechPolicy.Press, "Here Come the Synthetic Voters" (2026-08-16) — techpolicy.press
- 포스트에이아이, 6·3 지방선거 AI 예측 — post-ai.com
규정·정책
- AAPOR, Code of Professional Ethics and Practices (2026년 6월 개정) — aapor.org
- AAPOR, "Responsible AI Integration in Survey Research" (2026-05) — aapor.org (PDF)
- 중앙선거관리위원회, 「AI 활용 허위정보 대응 본격 시동」 (2023-08-31) — nec.go.kr
- Anthropic, "Preparing for global elections in 2024" — anthropic.com · "An update on our election safeguards" (2026-04) — anthropic.com
- OpenAI, Model Spec — model-spec.openai.com
사진 (모두 위키미디어 공용)
- 기표소: 「대한민국 21대 대통령선거 기표소 1」 revi, CC BY-SA 2.0 KR — commons.wikimedia.org (잘라서 씀, 같은 조건으로 이용 가능)
- 투표함: 「Korean ballots box」 revi, CC BY 2.0 KR — commons.wikimedia.org
- 스티커: 「Pile of "I Voted" stickers」 Funknendai, CC0 — commons.wikimedia.org


함께 읽기(8회): AI 합성 패널로 소비자 조사하기