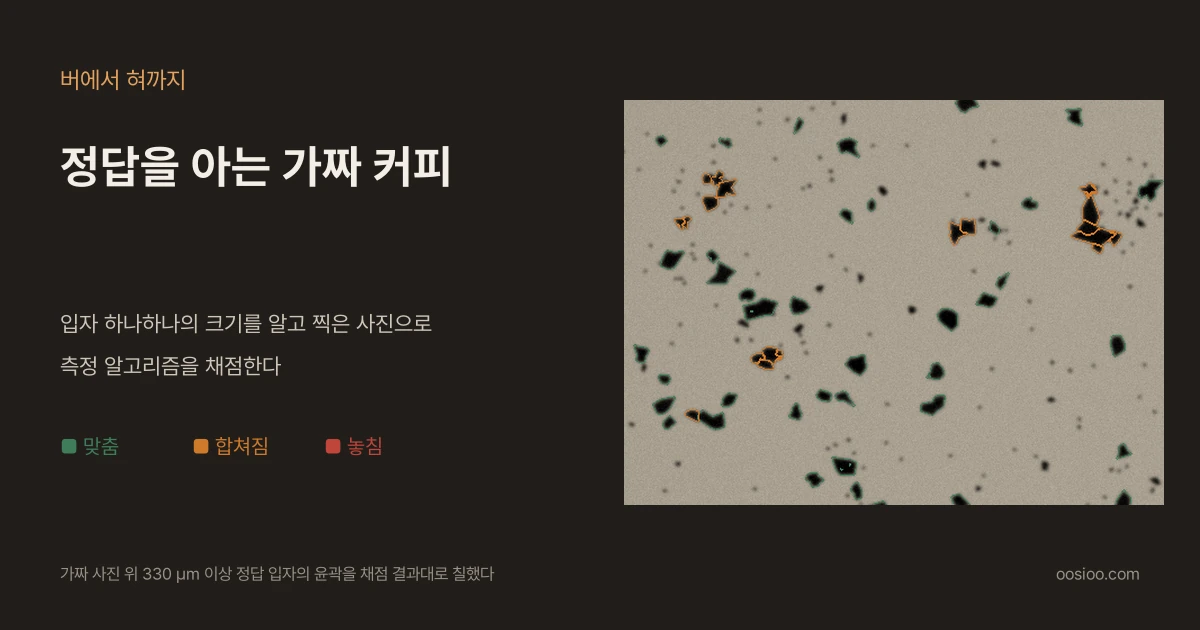
정답을 아는 가짜 커피
지금까지 가녜 예시 사진을 여러 번 쟀지만 그 숫자가 맞는지는 확인하지 못했다. 입자 하나하나의 크기를 아는 가짜 사진을 만들어 진짜 사진의 흐림·밝기 얼룩·잡음·모양에 맞춘 뒤, 이 연재의 측정 알고리즘을 채점했다. 매끈한 가짜에서 6%이던 부피 중앙값 오차가 진짜를 닮은 가짜에서는 33%였고, 오차 대부분은 붙은 입자가 한 덩어리로 잡히는 데서 왔다.
지금까지 이 연재는 가녜의 예시 사진 한 장을 여러 번 쟀다. 동전으로 배율을 맞추고, 배경을 펴고, 입자를 잘라 지름을 매기고, 개수와 부피로 셌다. 입자 1,572개의 등가원 지름 중앙값은 605 µm였다. 그런데 이 숫자가 맞는지는 한 번도 확인하지 못했다. 그 사진 속 입자의 진짜 크기를 아는 사람이 아무도 없기 때문이다.
지난 글에서는 정답을 아는 가상 가루를 체, 레이저, 카메라에 넣어 측정기끼리 비교했다. 이번에는 카메라 쪽의 알고리즘 자체를 채점한다. 입자 하나하나의 크기를 알고 있는 가짜 사진을 만들고, 그동안 써 온 측정 방법으로 재서 정답과 맞춰 본다.
사진에는 정답이 없다
알고리즘을 채점하려면 정답이 있어야 한다. 실제 사진에서 정답을 얻는 방법은 두 가지쯤 떠오른다. 사람이 입자를 하나하나 따라 그리거나, 같은 가루를 다른 측정기로 재는 것이다.
둘 다 생각보다 불확실하다. 사람이 그린 윤곽도 사람마다 다르다. 전자현미경 입자 사진을 다룬 륄레 등(2021)은 정답 마스크와 사람 작업자의 측정이 약 9 nm, 픽셀로는 1.2개만큼 어긋났다고 보고했다. 크기로 치면 5% 안팎이다. 다른 측정기는 지난 글에서 본 대로 저마다 다른 자를 댄다. 체로 잰 값을 정답 삼아 사진 알고리즘을 맞추면, 사진이 체를 흉내 내도록 길들이는 셈이 된다.
그래서 다른 분야에서는 정답을 아는 사진을 일부러 만든다. 카메라의 해상력을 잴 때 쓰는 1951년 미 공군 해상도 표나 ISO 12233의 기울어진 모서리 시험 판이 그런 것이다. 선의 간격을 알고 찍으니 흐려진 정도를 정확히 잴 수 있다. 세포 생물학에는 컴퓨터로 만든 세포 사진 묶음이 있다. 브로드 연구소의 BBBC005는 시뮬레이터로 그린 사진 19,200장으로, 한 장에 세포가 1개에서 100개까지 있고 초점 흐림을 48단계로 바꿔 가며 그렸다. 세포 수가 파일 이름에 적혀 있어서 세포를 세는 알고리즘을 바로 채점할 수 있다.
입자 크기 분석에서도 이 방법이 쓰인다. 프라이와 크루이스(2020)는 서로 붙고 일부 녹아 엉긴 나노 입자의 크기를 재는 신경망을 합성 사진만으로 학습시켰다. 사람이 일일이 표시하는 수고를 덜고 정답의 질도 높이기 위해서였다. 밀 등(2021)은 3차원 그래픽 프로그램 블렌더로 나노 입자 현미경 사진을 그려 학습시켰는데, 실제 사진으로 학습한 경우(F1 0.950)와 거의 같은 성능(F1 0.930)을 냈다.
커피 가루에서는 이렇게 채점한 연구를 찾지 못했다. 가녜의 coffeegrindsize 저장소에도 정답을 아는 시험은 없다. 그러니 직접 만들어 본다.
가짜 사진을 만드는 다섯 단계
가짜 사진은 다섯 단계로 만든다.
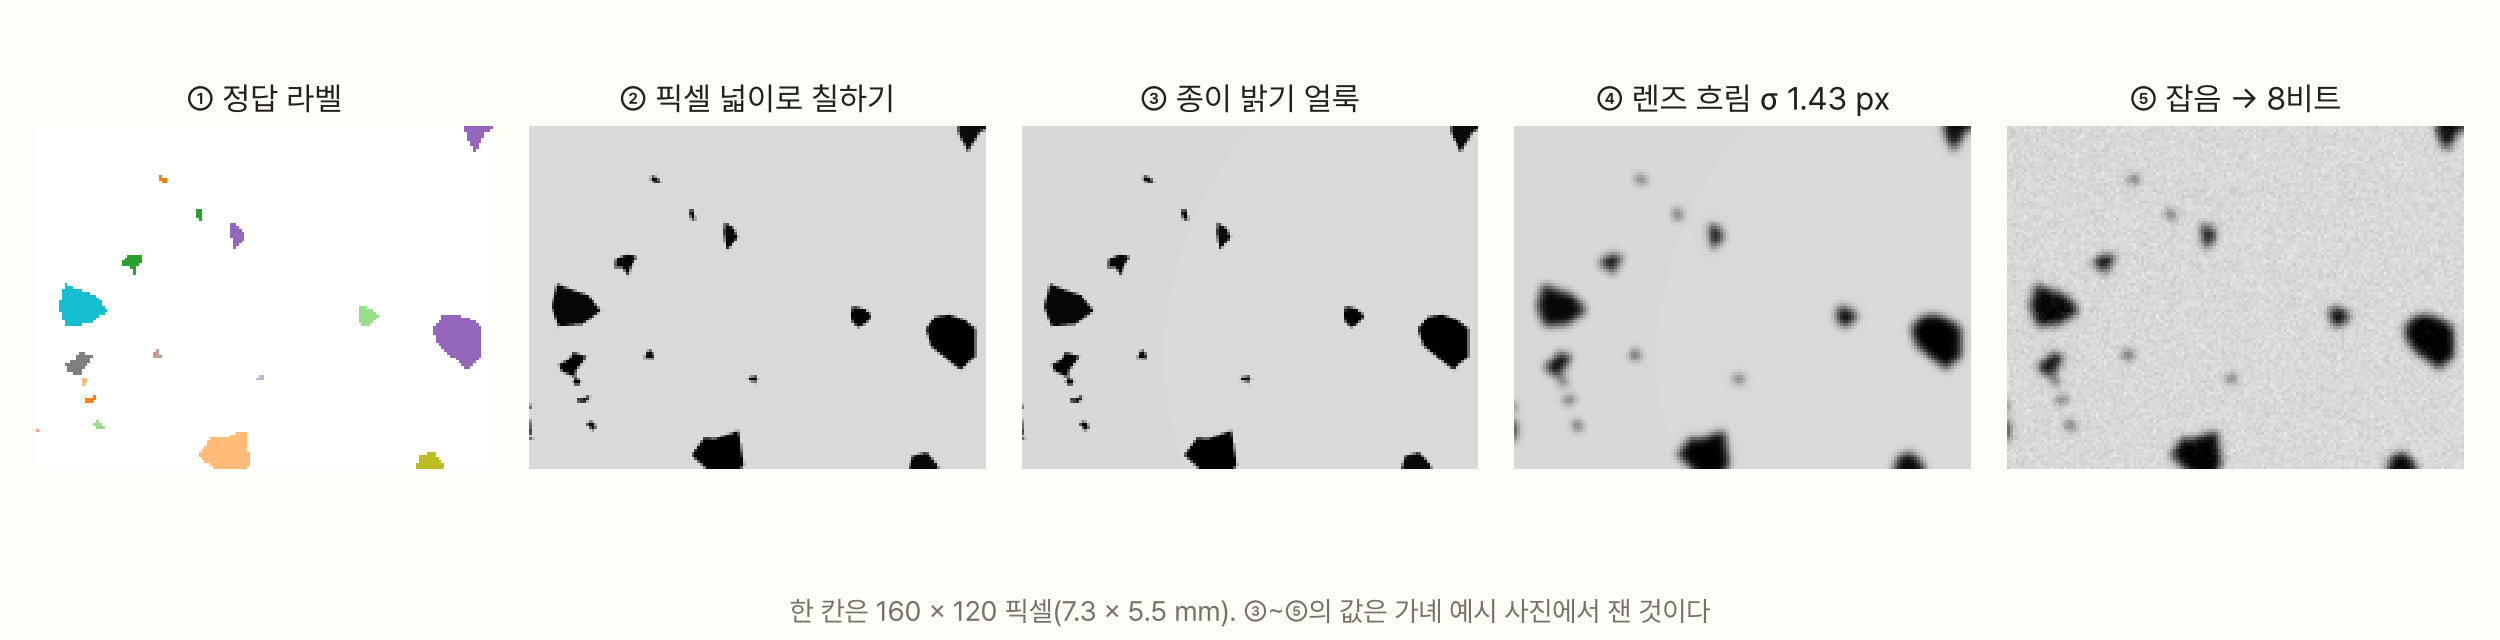
- 정답을 정한다. 입자 크기는 「개수로 세느냐 부피로 세느냐」에서 만든 이봉 모델에서 뽑는다. 굵은 봉우리는 가녜 사진에서 잰 입자 분포를 이은 것이고, 미분 봉우리는 무게의 20%를 차지한다. 보라와 브리젠(2026)이 커피 가루 분포를 10가지 혼합 분포로 맞춰 봤을 때도 커피 가루는 늘 봉우리가 두 개였다. 입자마다 길쭉함은 가녜 사진에서 잰 1,578개 값 가운데 하나를 고르고, 방향은 아무렇게나 돌린다. 지름 100 µm보다 작은 입자는 이 사진에서 2픽셀 남짓이라 그리지 않았다
- 픽셀로 칠한다. 입자를 네 배 큰 화면에 그린 다음 줄인다. 그래서 가장자리 픽셀은 입자가 덮은 넓이만큼만 어두워진다. 입자 번호를 칠한 큰 화면이 그대로 정답 라벨이 된다
- 종이 밝기에 얼룩을 넣는다. 가운데가 밝고 모서리로 갈수록 어두워진다
- 렌즈로 흐린다. 가우스 흐림을 건다
- 잡음을 넣고 8비트로 저장한다
3~5단계의 값은 가녜 예시 사진에서 쟀다. 큰 입자 300개의 가장자리를 따라 밝기를 재서 맞춰 보니 흐림은 σ 1.46픽셀이었다. 픽셀 넓이 효과를 빼면 렌즈 흐림은 σ 1.43픽셀이다. 종이 밝기는 가장 어두운 곳(하위 5%)이 가장 밝은 곳(상위 5%)의 74%였다. 입자에서 멀리 떨어진 빈 종이의 밝기 잡음은 2.4%, 가루가 덮은 넓이는 종이의 6.1%였다. 입자 속은 파란 채널에서 거의 0이다. 가녜가 파란 채널을 쓰는 이유도 여기 있다. 그의 설명서에 따르면 갈색에는 파란빛이 거의 없다.
가짜가 진짜를 닮았나
처음 만든 가짜는 이랬다. 입자를 매끈한 타원으로 그리고, 종이 위에 고르게 흩었다.
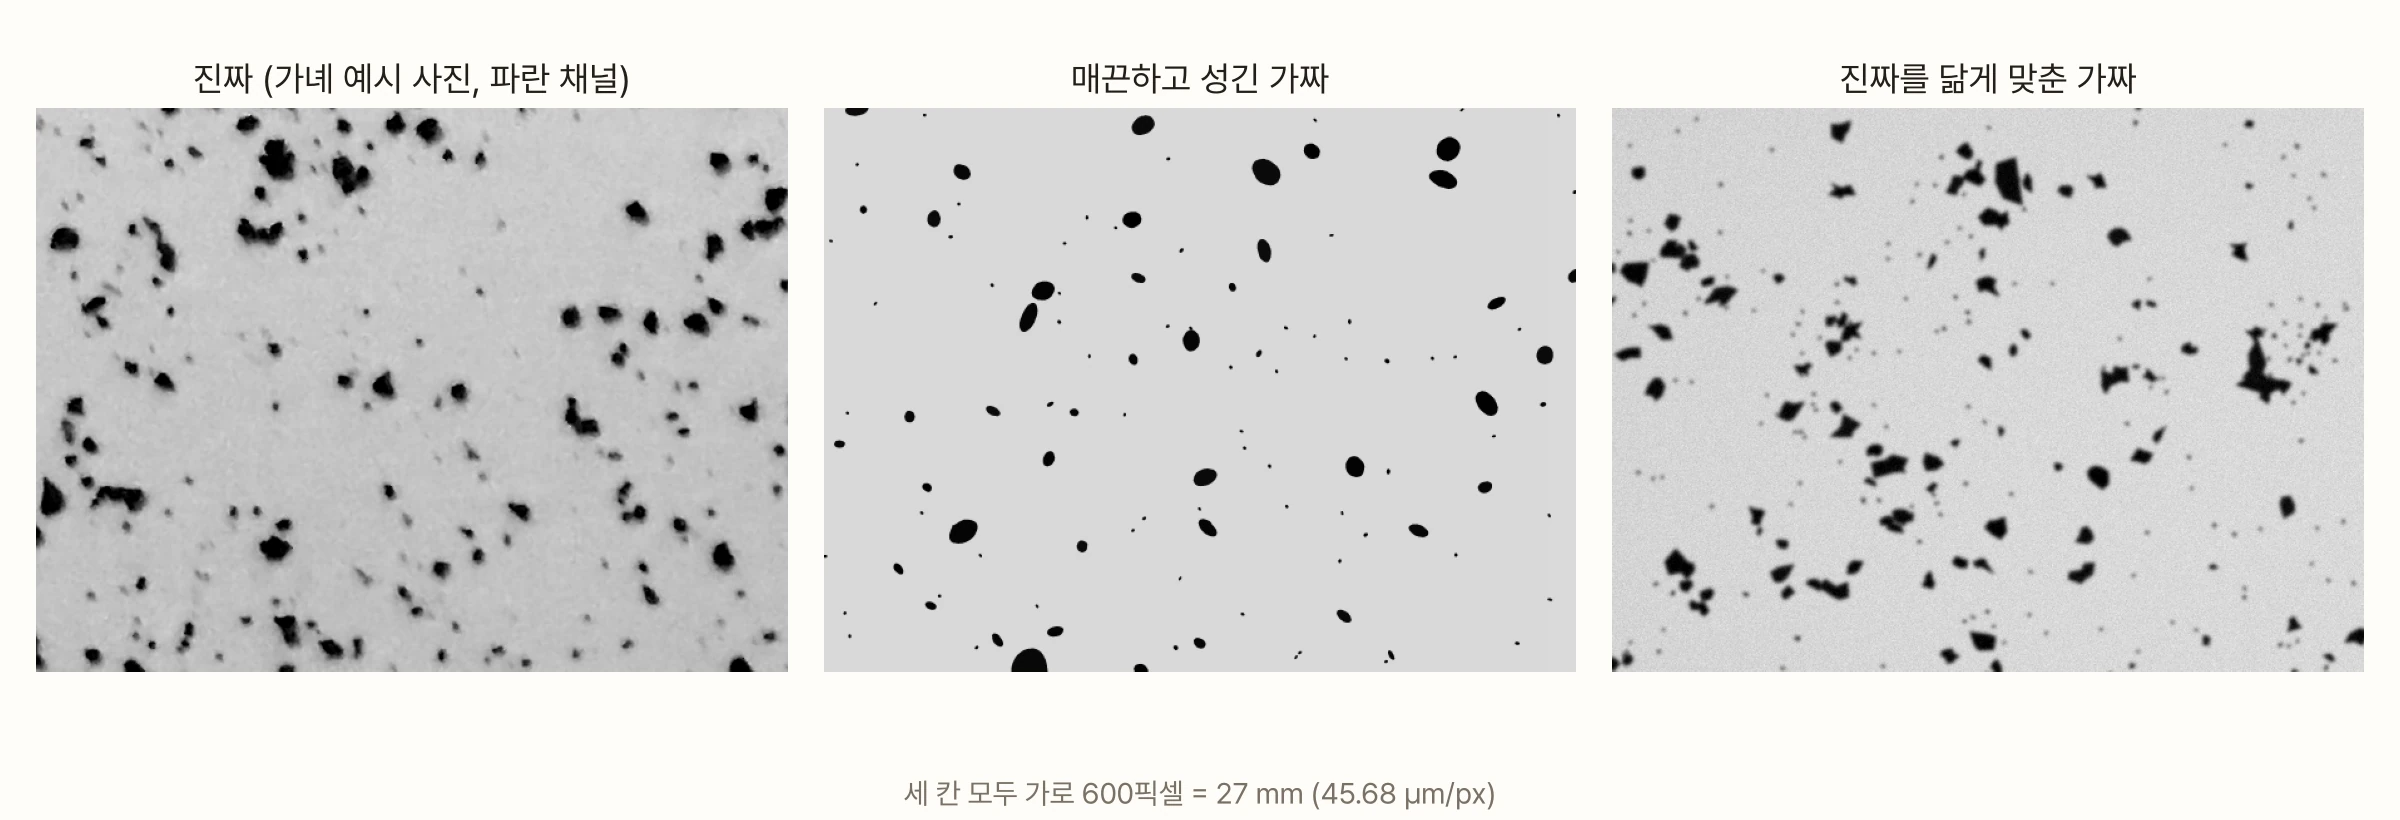
눈으로 봐도 다르다. 진짜 커피 조각은 모서리가 각지고, 여러 개가 한데 모여 떨어진다. 가짜는 너무 매끈하고 너무 고르다.
눈으로만 보면 어디까지 닮았는지 말하기 어렵다. 그래서 진짜와 가짜를 같은 측정 방법으로 재서 숫자로 비교했다. 덩어리 지름, 길쭉함, 볼록도(덩어리 넓이 ÷ 그것을 감싸는 가장 작은 볼록 다각형의 넓이), 볼록도가 0.8보다 낮은 덩어리의 몫, 그리고 덩어리 수다. 볼록도가 낮은 덩어리는 대개 입자 여럿이 붙은 것이다.
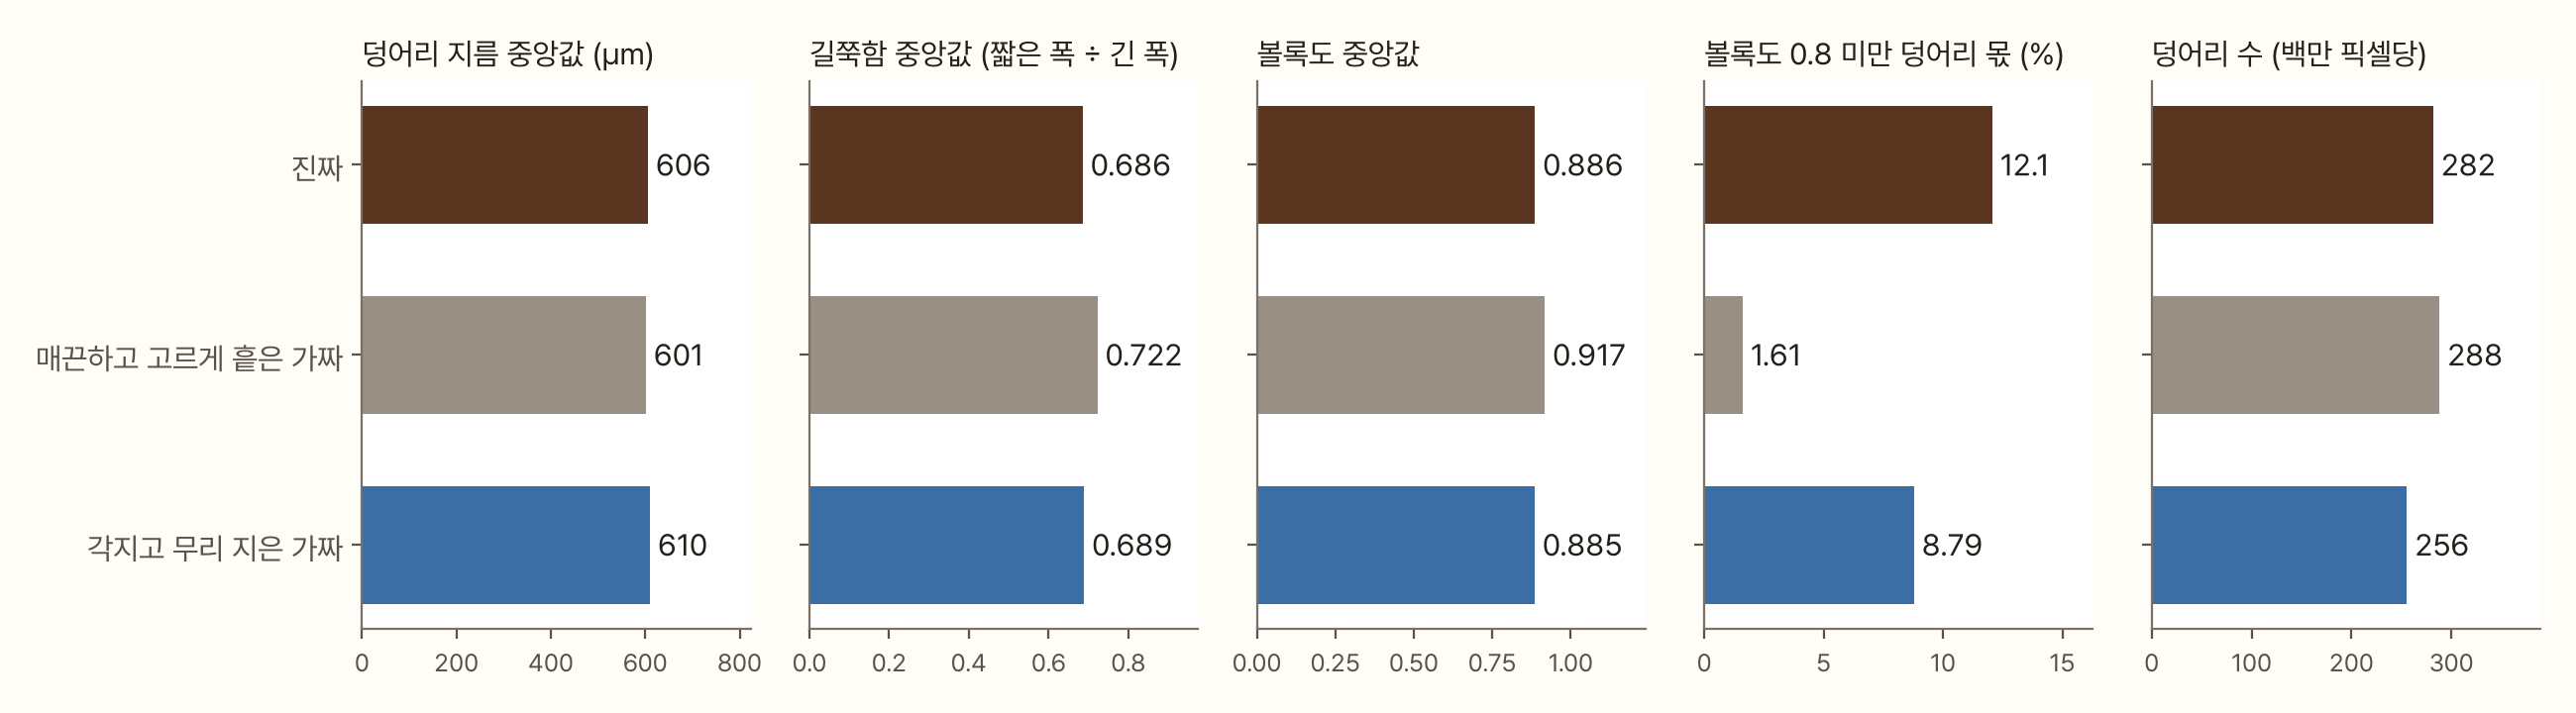
매끈한 가짜는 지름과 덩어리 수는 진짜와 맞았지만 모양이 달랐다. 볼록도가 0.8보다 낮은 덩어리가 진짜는 12.1%인데 매끈한 가짜는 1.6%뿐이었다. 그래서 입자를 꼭짓점 6~10개짜리 각진 조각으로 바꾸고, 입자의 절반은 지름 1 mm쯤의 무리 안에 떨어지게 했다. 각진 정도와 무리의 크기를 몇 가지로 바꿔 가며 진짜의 통계에 가장 가까운 값을 골랐다. 이렇게 맞춘 가짜는 지름 610 µm, 길쭉함 0.689, 볼록도 0.885로 진짜와 거의 같아졌다. 볼록도 0.8 미만의 몫(8.8%)과 덩어리 수(256)는 아직 진짜보다 조금 적다.
이 과정을 건너뛰면 안 되는 이유가 있다. 역문제 분야에는 '역범죄(inverse crime)'라는 말이 있다. 가짜 자료를 만들 때 쓴 가정과 그 자료를 풀 때 쓴 가정이 같으면, 결과가 실제보다 훨씬 좋아 보이는 일을 가리킨다. 이 말을 처음 쓴 콜턴과 크레스는 합성 자료를 만드는 쪽이 푸는 쪽과 아무 연결도 없어야 한다고 강조했다. 우리 경우로 옮기면 이렇다. 측정 알고리즘은 입자가 떨어져 있고, 종이가 고르고, 가장자리가 또렷하다고 기대한다. 가짜도 그렇게 만들면 알고리즘은 시험을 쉽게 통과한다. 반대 방향의 처방도 있다. 로봇 학습에서 쓰는 '도메인 무작위화'는 가짜를 진짜 하나에 맞추는 대신 조건을 아주 넓게 흔들어, 진짜가 그 많은 변형 가운데 하나로 보이게 만든다(토빈 등, 2017). 이 글에서는 먼저 진짜 사진 한 장에 맞추는 쪽을 택했다.
채점하는 법
채점할 알고리즘은 이 연재에서 써 온 방법 그대로다. 파란 채널에서 빈 종이의 밝기를 추정해 사진을 펴고, 종이 밝기의 58.8%보다 어두운 픽셀을 입자로 본다. 58.8%는 coffeegrindsize의 기본값이다. 맞닿은 픽셀끼리 덩어리로 묶고, 40픽셀보다 작은 덩어리는 버린다. 40픽셀은 이 배율에서 지름 330 µm쯤이다. 그래서 채점도 정답 지름이 330 µm 이상인 입자만 대상으로 했다.
입자마다 정답 영역과 측정 덩어리가 얼마나 겹치는지 본다. 겹친 넓이를 둘을 합친 넓이로 나눈 값(IoU)이 0.5 이상이면 '맞춤'이다. 사물 검출 대회 PASCAL VOC가 정답 판정에 쓴 기준이다. 덩어리가 정답 입자를 절반 넘게 덮었는데 IoU가 0.5에 못 미치면, 이웃과 붙어 한 덩어리로 잡힌 것이니 '합쳐짐'으로 본다. 어느 덩어리도 절반을 덮지 못하면 '놓침'이다.
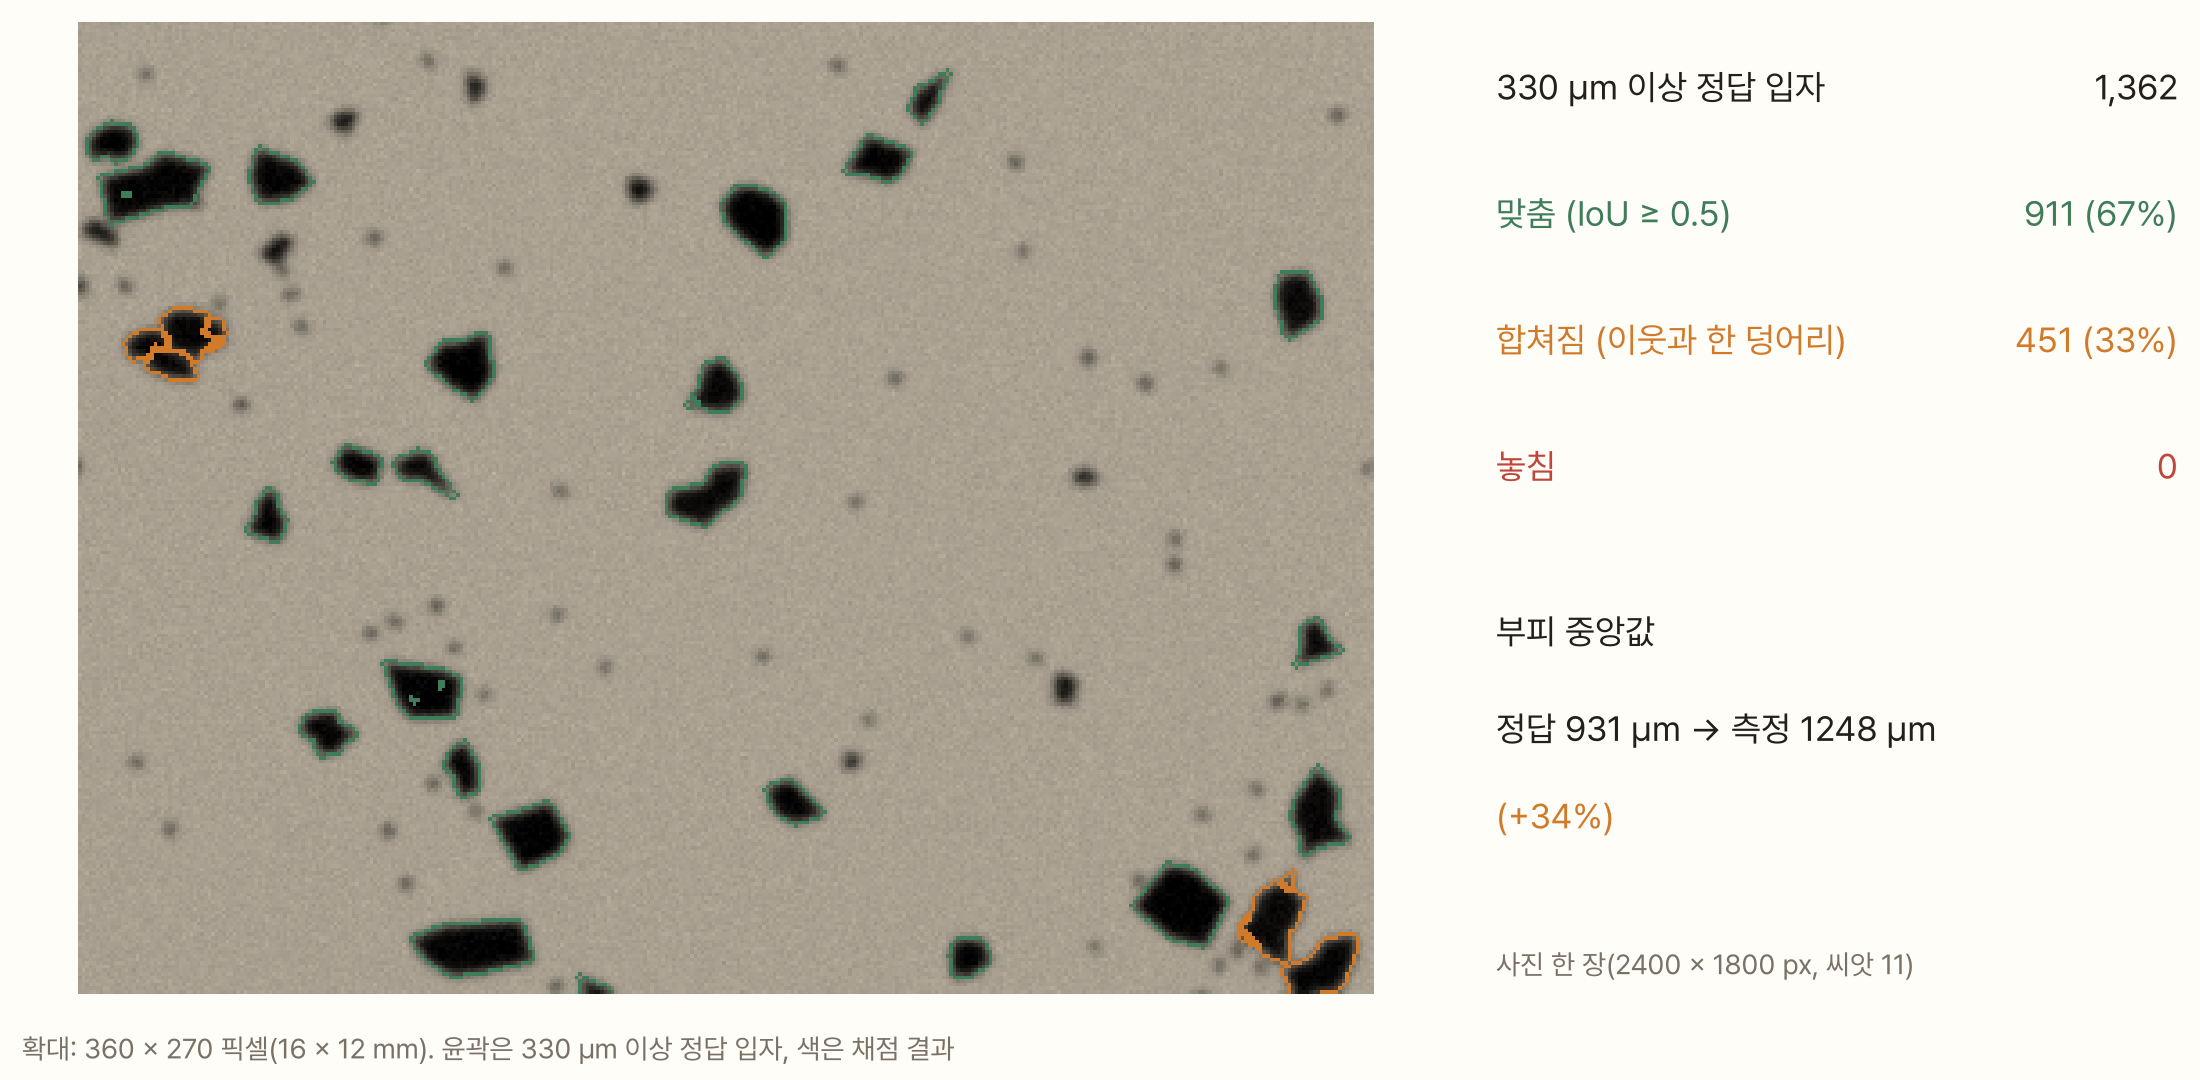
진짜를 닮은 가짜 세 장으로 채점한 평균은 이렇다.
| 매끈하고 성긴 가짜 | 진짜를 닮은 가짜 | |
|---|---|---|
| 맞춘 큰 입자 | 95% | 70% |
| 합쳐진 큰 입자 | 5% | 30% |
| 놓친 큰 입자 | 0% | 0% |
| 맞춘 입자의 크기 치우침 | +2.7% | +6.2% |
| 개수 중앙값 오차 | +0.8% | +8.0% |
| 부피 중앙값 오차 | +5.7% | +33% |
매끈하고 성긴 가짜로만 채점했다면 이 알고리즘은 우등생이다. 개수 중앙값은 1% 안에서, 부피 중앙값은 6% 안에서 맞췄다. 진짜를 닮은 가짜에서는 부피 중앙값이 33% 크게 나왔다. 같은 알고리즘인데, 시험지가 바뀌자 점수가 달라졌다.
놓친 입자는 없었다. 330 µm 이상이면 이 해상도에서 모두 보인다. 오차는 거의 다 합쳐짐에서 왔다. 붙은 입자 두세 개가 한 덩어리로 잡히면 지름이 1.4~1.7배 큰 입자 하나가 생긴다. 부피는 지름의 세제곱이라 이런 가짜 큰 입자가 부피 분포를 크게 끌어올린다.
무엇이 오차를 만드나
조건을 하나씩 바꿔 가며 같은 채점을 되풀이했다. 나머지 조건은 진짜를 닮은 가짜 그대로 두고, 사진마다 씨앗을 바꿔 세 장씩 평균했다.
가루 밀도
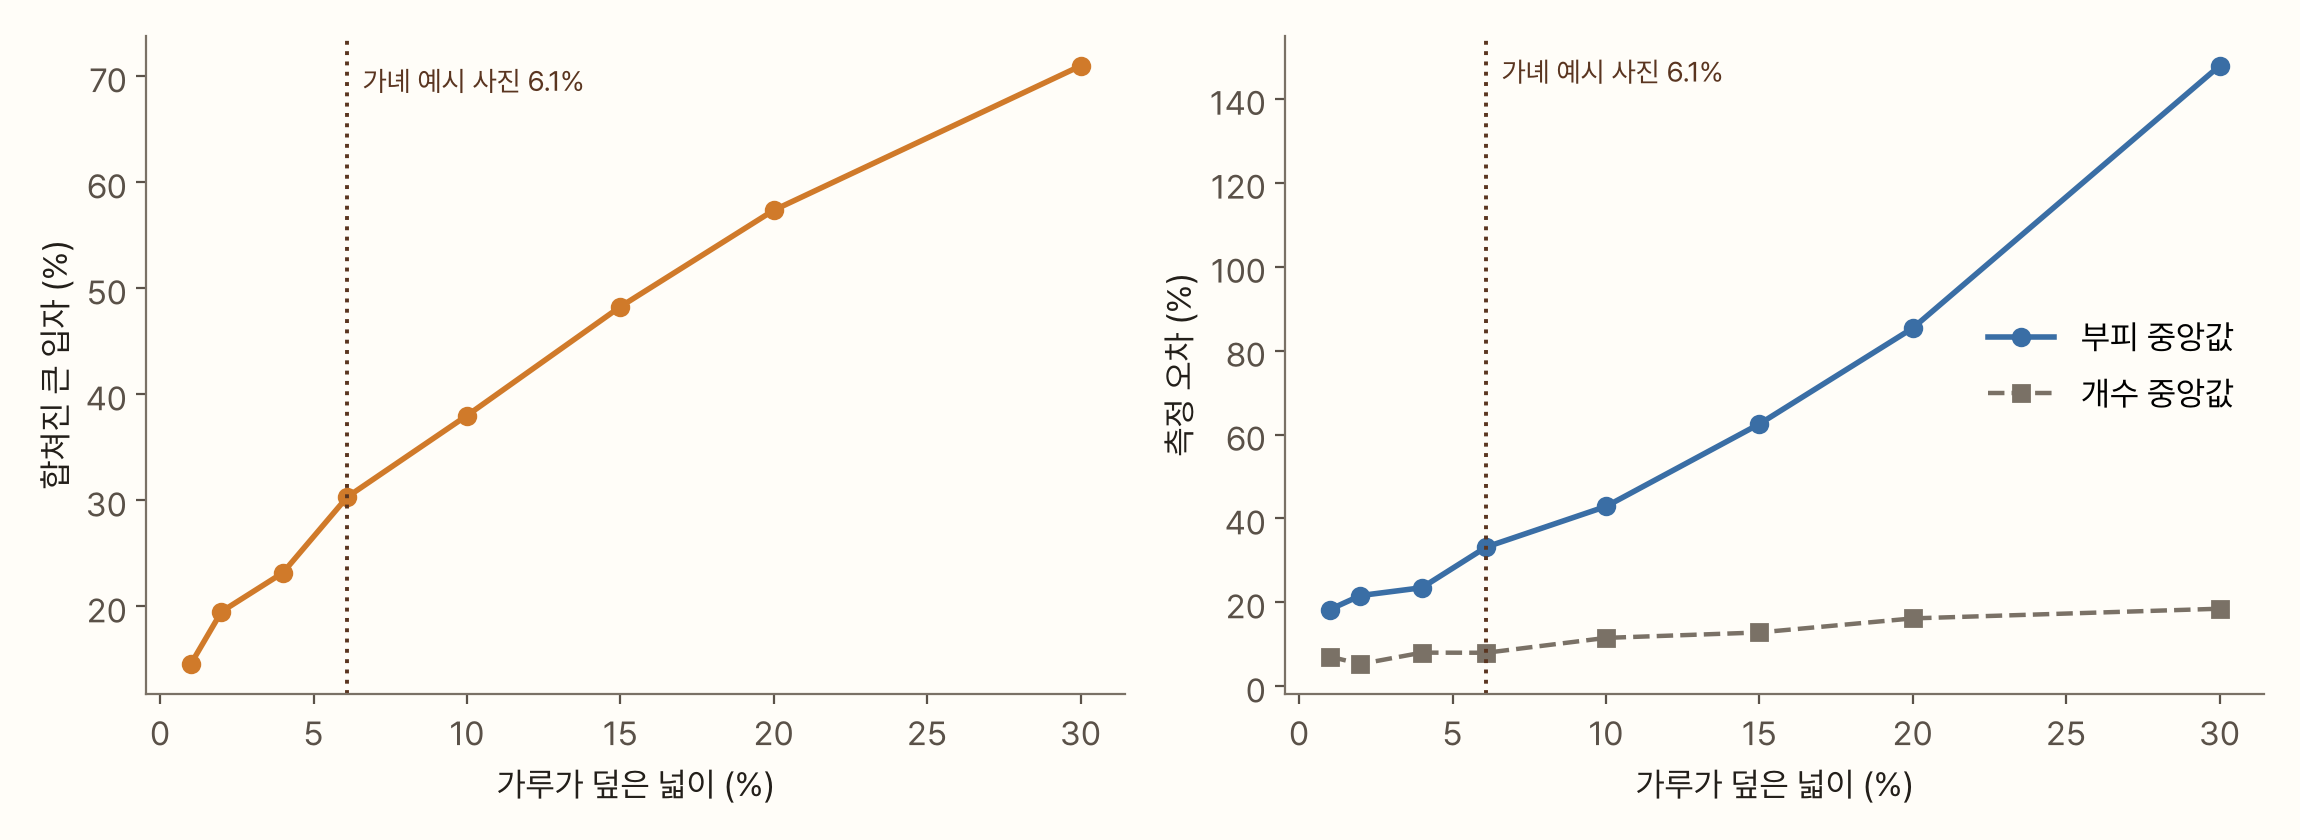
가루를 성기게 뿌릴수록 합쳐짐이 준다. 가녜 사진만큼(6.1%) 뿌리면 큰 입자의 30%가 합쳐지고, 부피 중앙값은 33% 크게 나온다. 30%를 덮으면 큰 입자 열에 일곱이 합쳐지고 부피 중앙값은 2.5배가 된다.
눈여겨볼 곳은 왼쪽 끝이다. 종이의 1%만 덮을 만큼 아주 성기게 뿌려도 합쳐짐이 15% 남는다. 가루가 무리 지어 떨어지기 때문이다. 고르게 흩어진 매끈한 가짜는 2%를 덮어도 5%만 합쳐졌다. 성기게 뿌리는 것만으로는 부족하고, 뭉친 가루를 흩어 줘야 한다.
정지 화상 분석 국제 표준 ISO 13322-1은 이 문제를 첫머리에 둔다. "측정은 떨어져 있는 입자에 대해 해야 한다는 것이 이 방법의 가장 중요한 요건이다. 제대로 나누지 않고 하나로 잰 맞닿은 입자는 오차를 만든다." 표준은 이어서, 맞닿은 입자는 화상 분석만으로 믿을 만하게 찾기 어려운 경우가 많으니 한 화면의 입자 수를 늘리고 줄여 가며 그 영향을 실험으로 확인하라고 권한다. 위 그래프가 바로 그 실험이다. 가녜의 설명서도 입자를 5픽셀쯤 떨어뜨려 놓으라고 한다.
문턱이 만드는 치우침
합쳐짐이 없는 깨끗한 경우에도 맞춘 입자는 2.7% 크게 잡혔다. 원인은 58.8%라는 문턱에 있다. 입자가 반만 덮은 가장자리 픽셀의 밝기는 종이의 50%쯤이다. 58.8%보다 어두우니 입자로 잡힌다. 계산해 보면 입자가 41% 이상 덮은 픽셀부터 입자로 센다. 넓이를 반올림이 아니라 올림에 가깝게 세는 셈이라 입자가 조금씩 커진다.
흐림이 끼면 이 치우침이 커진다. 흐린 가장자리에서 밝기는 입자에서 종이로 서서히 오르는데, 문턱이 그 중간(50%)보다 높으니 문턱을 넘는 자리가 입자 바깥쪽으로 밀려난다. 가우스 흐림이라면 0.22σ만큼이다. 가녜 사진의 흐림(σ 1.43픽셀)이면 양쪽 가장자리가 0.3픽셀씩 밀려서, 지름 13픽셀(600 µm) 입자는 5%쯤 커진다. 채점에서 나온 치우침은 6.2%였다.
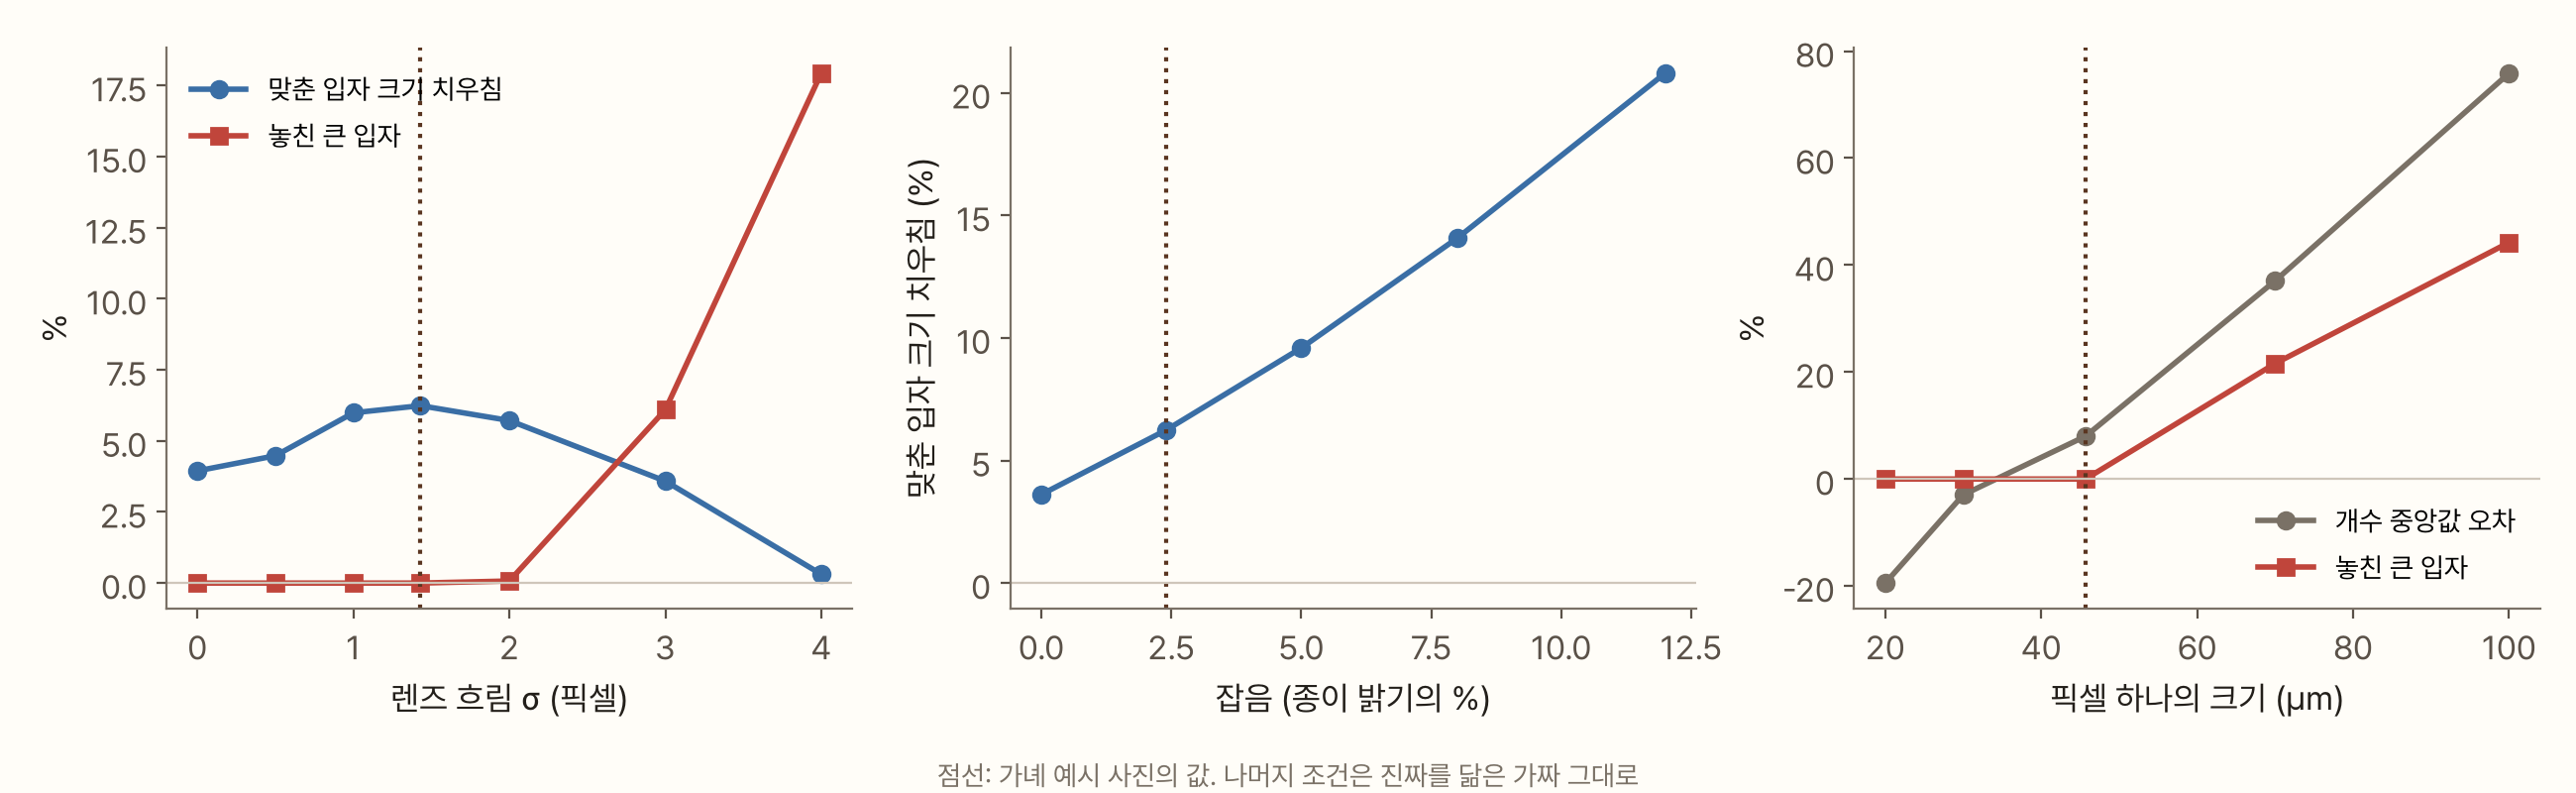
흐림이 더 심해지면(σ 3픽셀 이상) 이번에는 작은 입자가 사라지기 시작한다. 흐려져서 가장 어두운 곳도 문턱까지 내려가지 못하기 때문이다. σ 4픽셀이면 330 µm 이상 입자의 18%를 놓친다. 치우침 그래프가 다시 내려가는 것도 이 때문이다. 크게 잡히던 작은 입자가 아예 빠지니 남은 입자의 치우침이 줄어 보인다.
잡음은 생각보다 크게 작용했다. 종이 밝기의 12%만큼 잡음이 끼면 맞춘 입자가 21% 크게 잡혔다. 가장자리 근처에서 잡음 때문에 우연히 문턱보다 어두워진 종이 픽셀이 입자에 붙기 때문이다.
해상도는 「픽셀 하나의 크기」에서 본 대로다. 같은 사진을 픽셀 하나에 70 µm로 찍으면 40픽셀 하한이 지름 500 µm가 되어, 330 µm 이상 입자의 22%를 놓친다. 거꾸로 20 µm로 찍으면 개수 중앙값이 20% 작게 나온다. 이건 오차라기보다 정의의 문제다. 330 µm보다 작은 입자까지 보이니, 330 µm 이상만 센 정답보다 중앙값이 작아진다. 같은 알고리즘이라도 해상도를 바꾸면 무엇을 세는지가 바뀐다.
고쳐 보기
정답이 있으니 고친 효과도 잴 수 있다. 세 가지를 시험했다.
- 문턱을 0.5로 낮춘다. 입자가 반 넘게 덮은 픽셀만 센다
- 붙은 입자를 나눈다. 덩어리 안에서 가장자리로부터의 거리가 봉우리를 이루는 곳마다 씨앗을 두고, 분수령(watershed) 방식으로 덩어리를 가른다. 화상 분석에서 흔히 쓰는 방법이다
- 볼록도가 0.85보다 낮은 덩어리를 버린다. 붙은 입자로 보이는 덩어리는 아예 세지 않는다. 「지름이란 무엇인가」에서 모양 통계를 낼 때 쓴 거르기다
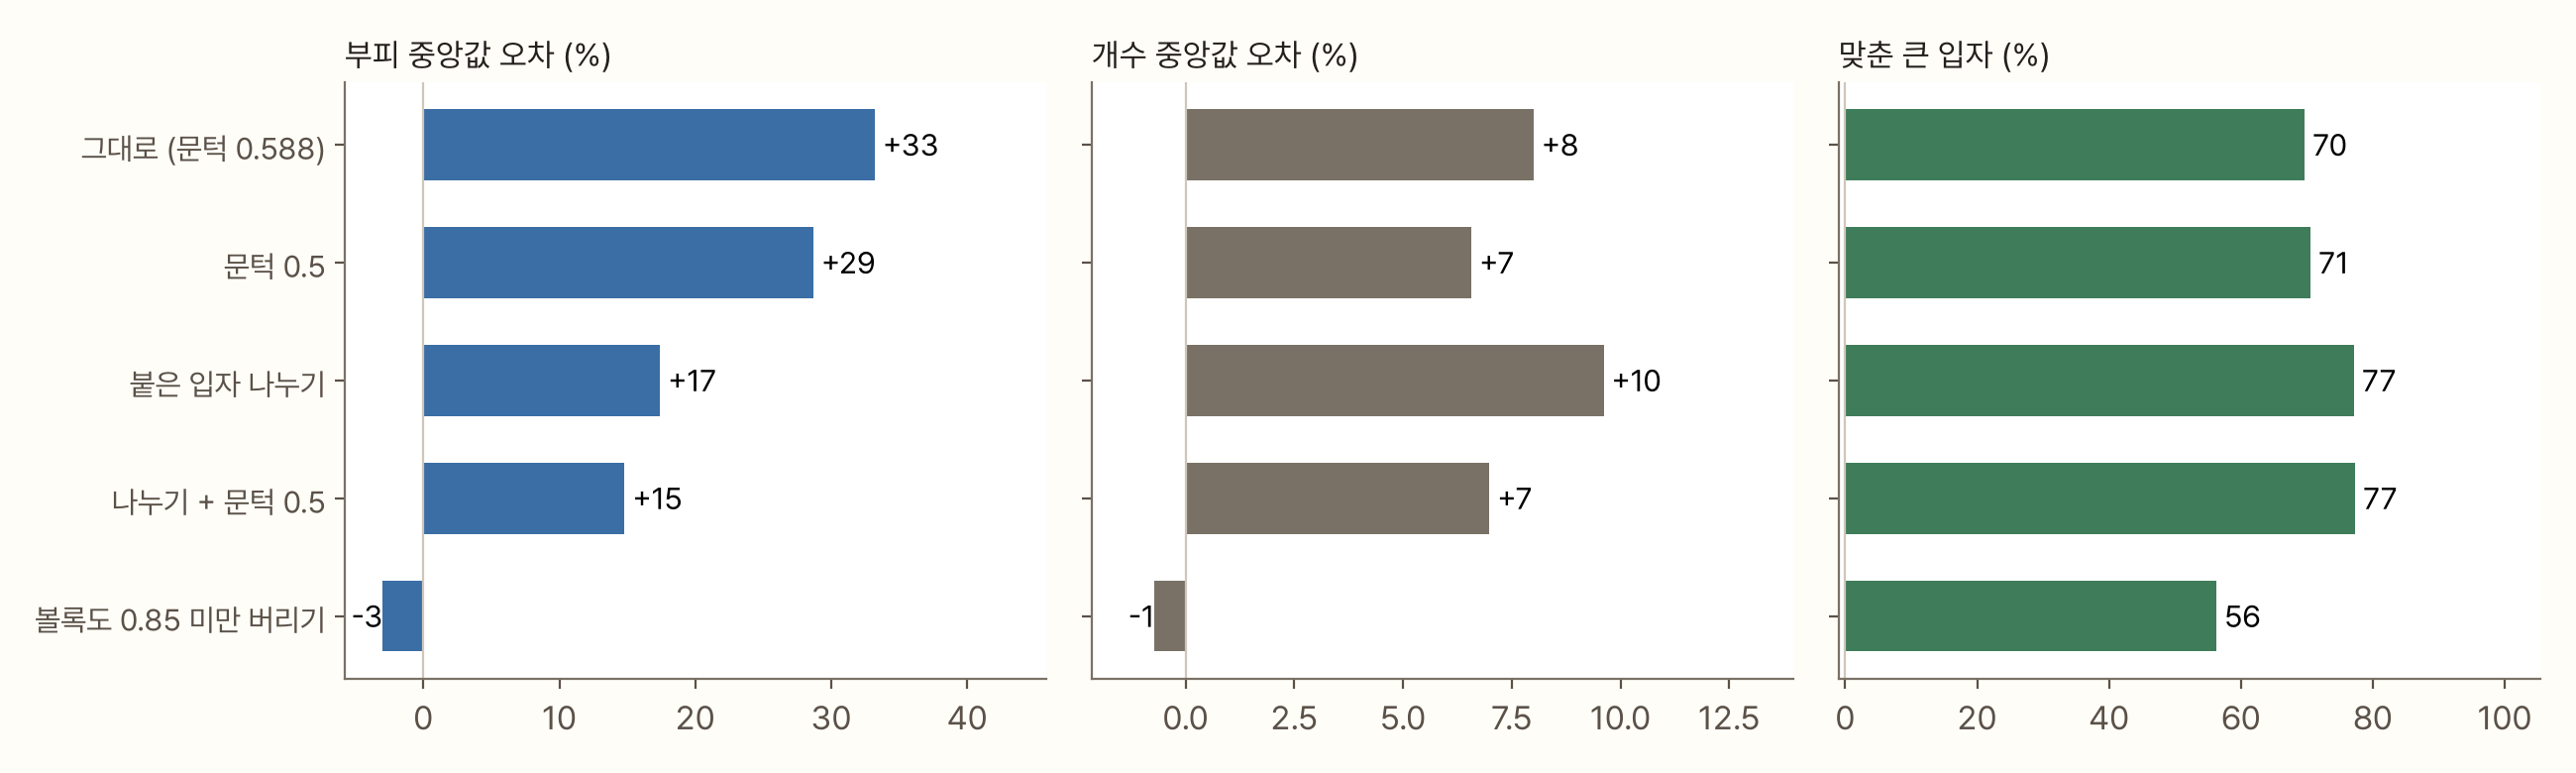
문턱을 0.5로 낮추면 맞춘 입자의 크기 치우침은 +6.2%에서 −0.2%로 사라진다. 하지만 부피 중앙값 오차는 33%에서 29%로 조금 줄 뿐이다. 오차의 대부분은 치우침이 아니라 합쳐짐에서 오기 때문이다.
붙은 입자를 나누면 부피 중앙값 오차가 절반(+17%)으로 줄고, 문턱 0.5와 함께 쓰면 +15%가 된다. 그래도 큰 입자의 21%는 여전히 합쳐진 채로 남는다. 각진 조각이 겹쳐 붙으면 거리 봉우리가 하나뿐이라 나눌 자리를 못 찾는다.
볼록도로 거르면 숫자는 가장 좋아 보인다. 부피 중앙값 오차 −3%, 개수 중앙값 오차 −1%다. 대신 큰 입자의 44%를 버린다. 버린 덩어리가 크기와 상관없이 고르게 뽑혔다면 남은 입자의 분포는 그대로일 테니, 이 방법은 버리는 만큼 사진을 더 찍으면 된다. 문제는 큰 입자일수록 이웃과 붙기 쉬워 큰 쪽이 더 많이 버려진다는 점이다. 오차가 0이 아니라 −3%인 이유다.
여기서 다시 역범죄를 떠올려야 한다. 이 가짜는 진짜 사진의 볼록도 통계에 맞춰 만들었다. 볼록도로 거르는 방법이 이 가짜에서 잘 통하는 것은 어느 정도 당연하다. 진짜 커피에서도 같은 만큼 통한다고 말하려면, 볼록도와 상관없는 다른 성질로도 가짜와 진짜가 닮았는지 확인해야 한다.
coffeegrindsize에도 붙은 덩어리를 쪼개는 기능이 있다. 가장자리 근처의 밝기 변화를 보고 덩어리를 나눈다. 코드에 남은 주석을 보면 이 기능의 핵심 값을 판이 바뀔 때마다 0.07에서 0.2로, 다시 0.35로 바꿨다. 0.07은 "너무 공격적"이었고, 0.35는 "Lido와 Forte 사진에서 훨씬 나아 보인다"고 적혀 있다. 두 그라인더의 사진을 눈으로 보며 맞춘 것이다. 정답을 아는 사진이 있었다면 이 값도 숫자로 고를 수 있었을 것이다.
직접 해 보기
아래 시뮬레이션에서 가짜 사진을 직접 만들고 채점할 수 있다. 사진은 720 × 540픽셀로 본문보다 작아서, 큰 입자가 100여 개뿐이라 숫자가 사진마다 조금씩 출렁인다. '다른 가루 뿌리기'를 몇 번 눌러 보면 그 출렁임도 볼 수 있다.
'매끈하고 성긴 가짜'를 누르면 점수가 거의 만점이 되고, '진짜를 닮은 가짜'로 돌아오면 주황 윤곽이 늘어난다. 무리 짓기를 0으로 내리거나 가루 밀도를 바꿔 보자. '진짜 사진 재 보기'를 누르면 가녜 사진의 같은 크기 부분을 같은 알고리즘으로 잰다. 진짜 사진은 정답이 없어서 측정 결과만 볼 수 있다.
이 실험이 빠뜨린 것
- 가짜는 평면에 칠한 그림이다. 실제 입자는 입체라서 그림자와 반사광이 생긴다. 입자 둘레의 그림자나 옅은 테두리 같은 것은 이 가짜에 없다
- 100 µm보다 작은 미분은 그리지 않았다. 실제 사진에서는 이런 미분이 종이를 조금 어둡게 하거나, 굵은 입자에 붙어 테두리를 넓힌다
- 무리 짓는 방식은 단순한 모형이다. 입자 절반을 지름 1 mm쯤의 무리에 무작위로 떨어뜨렸다. 실제 가루가 왜, 어떻게 뭉치는지는 반영하지 않았다
- 가짜는 진짜 사진 한 장의 통계에 맞췄다. 그 사진의 조명과 카메라와 뿌리는 방식이 바뀌면 다시 맞춰야 한다. 볼록도 0.8 미만 덩어리의 몫과 덩어리 수는 아직 진짜보다 적다
- 채점한 알고리즘은 이 연재의 방법 하나다. coffeegrindsize의 덩어리 쪼개기나 다른 프로그램은 채점하지 않았다
- 진짜 사진의 오차는 여전히 모른다. 이 글이 보여 준 것은 진짜를 닮은 가짜에서의 오차다. 진짜에서 얼마나 틀리는지는 크기를 아는 실물로 확인해야 한다
정리
- 실제 사진에는 정답이 없다. 사람이 그린 윤곽도 5%쯤 흔들리고, 다른 측정기는 다른 자를 댄다. 그래서 입자 하나하나의 크기를 아는 가짜 사진을 만들어 알고리즘을 채점했다
- 가짜는 정답 라벨 → 픽셀 넓이로 칠하기 → 종이 밝기 얼룩 → 렌즈 흐림 → 잡음의 다섯 단계로 만들었다. 흐림 σ 1.43픽셀, 밝기 얼룩 26%, 잡음 2.4%, 덮인 넓이 6.1%는 가녜 예시 사진에서 쟀다
- 매끈한 타원을 고르게 흩은 가짜는 진짜보다 모양이 지나치게 매끈했다. 각진 조각을 무리 지어 떨어뜨리자 같은 측정기로 잰 지름·길쭉함·볼록도가 진짜와 거의 같아졌다
- 매끈하고 성긴 가짜에서 부피 중앙값 오차는 +6%였지만 진짜를 닮은 가짜에서는 +33%였다. 가짜를 만드는 가정이 알고리즘의 가정과 같으면 점수가 부풀려진다(역범죄)
- 오차는 대부분 붙은 입자가 한 덩어리로 잡히는 합쳐짐에서 왔다. 큰 입자의 30%가 합쳐졌고, 가루가 무리 지어 떨어지면 종이의 1%만 덮어도 15%가 합쳐진다
- 문턱 0.588은 입자를 2.7~6% 크게 잰다. 붙은 입자를 나누면 부피 중앙값 오차가 +15%까지 줄고, 볼록도로 거르면 −3%가 되지만 큰 입자의 44%를 버린다
정답을 아는 사진은 알고리즘의 시험지다. 시험지가 실제 문제를 닮았는지부터 확인해야 점수를 믿을 수 있다.
참고문헌
- Rühle B, Krumrey JF, Hodoroaba V-D (2021). Workflow towards automated segmentation of agglomerated, non-spherical particles from electron microscopy images using artificial neural networks. Scientific Reports 11, 4942. doi:10.1038/s41598-021-84287-6 — 정답 마스크와 사람 작업자 차이 약 9 nm(1.2 px, 약 5%)
- Frei M, Kruis FE (2020). Image-based size analysis of agglomerated and partially sintered particles via convolutional neural networks. Powder Technology 360, 324–336. doi:10.1016/j.powtec.2019.10.020 — 합성 사진만으로 학습
- Mill L, et al. (2021). Synthetic Image Rendering Solves Annotation Problem in Deep Learning Nanoparticle Segmentation. Small Methods 5, 2100223. doi:10.1002/smtd.202100223 — F1 합성 학습 0.930 대 실제 학습 0.950(SiO₂, arXiv:2011.10505 판)
- Broad Bioimage Benchmark Collection. BBBC005 — 합성 세포 사진 19,200장, 세포 1~100개, 초점 흐림 48단계. 링크
- Lehmussola A, et al. (2007). Computational Framework for Simulating Fluorescence Microscope Images With Cell Populations. IEEE Transactions on Medical Imaging 26(7), 1010–1016. doi:10.1109/TMI.2007.896925
- Bora M, Briesen H (2026). Characterization of Bimodal Particle Size Distribution of Ground Coffee Powder. Journal of Food Process Engineering 49(6), e70645. doi:10.1111/jfpe.70645
- Wirgin A (2004). The inverse crime. arXiv:math-ph/0401050 — 역범죄의 정의, 콜턴과 크레스(1992)의 "합성 자료는 역풀이와 아무 연결도 없는 순방향 풀이로 만들어야 한다"
- Kaipio J, Somersalo E (2007). Statistical inverse problems: Discretization, model reduction and inverse crimes. Journal of Computational and Applied Mathematics 198(2), 493–504. doi:10.1016/j.cam.2005.09.027
- Everingham M, et al. (2010). The PASCAL Visual Object Classes (VOC) Challenge. International Journal of Computer Vision 88, 303–338. doi:10.1007/s11263-009-0275-4 — IoU 50% 초과를 맞춘 검출로 판정
- ISO 13322-1:2014. Particle size analysis — Image analysis methods — Part 1: Static image analysis methods — 떨어진 입자 측정이 가장 중요한 요건, 입자 수를 바꿔 맞닿음의 영향 확인(5.2절). 공식 샘플
- Gagné J. coffeegrindsize. GitHub. 링크 — 파란 채널, 기본 문턱 58.8%, 입자를 약 5 px 떨어뜨리라는 설명서 권고, 덩어리 쪼개기 값의 변경 주석
- Tobin J, et al. (2017). Domain randomization for transferring deep neural networks from simulation to the real world. IROS 2017. arXiv:1703.06907
이미지 출처
- 모든 그림과 시뮬레이션: 직접 제작. 진짜 사진은 Jonathan Gagné의 coffeegrindsize 예시 사진(MIT 라이선스)의 일부이고, 가짜 입자의 길쭉함도 이 사진에서 잰 값이다