심리검사 하나를 만들었다가 스무 개가 됐다 — 검사 한 종을 파일 하나로 늘리는 구조
재미로 만든 간이 검사 하나에서 시작해, 검사 한 종을 파일 하나로 얹으면 채점·리포트·화면이 알아서 붙는 틀로 바꿨더니 스무 개가 됐다. 딸깍의 진짜 힘은 하나를 뚝딱 만드는 게 아니라 스물한 번째를 공짜로 만들 판을 짜두는 데 있다. 다만 국내외 사례를 둘러보니, 검사처럼 보이는 걸 만드는 일과 진짜 검사를 만드는 일은 전혀 다른 난이도였다.
재미로 성격검사 같은 걸 하나 만들었다. 문항에 답하면 점수를 내고, 그걸 바탕으로 "당신은 이런 사람이다" 하는 리포트를 뽑아주는 물건이다. 가족이랑 해보니 은근 재밌었다. 정식 검사는 아니고, 그냥 자기 성향을 들여다보는 간이판이다.
그랬더니 욕심이 났다. 성격 말고 흥미나 강점, 관계 성향 같은 것도 들여다보는 비슷한 검사를 더 만들어보고 싶었다. 문제는 검사 하나를 통째로 복사해서 문항만 갈아끼우는 식으로 하면 열 개째쯤에서 손이 나가떨어진다는 거다. 채점 로직, 리포트 생성, 화면을 검사마다 따로 관리하는 순간 지옥이 열린다.
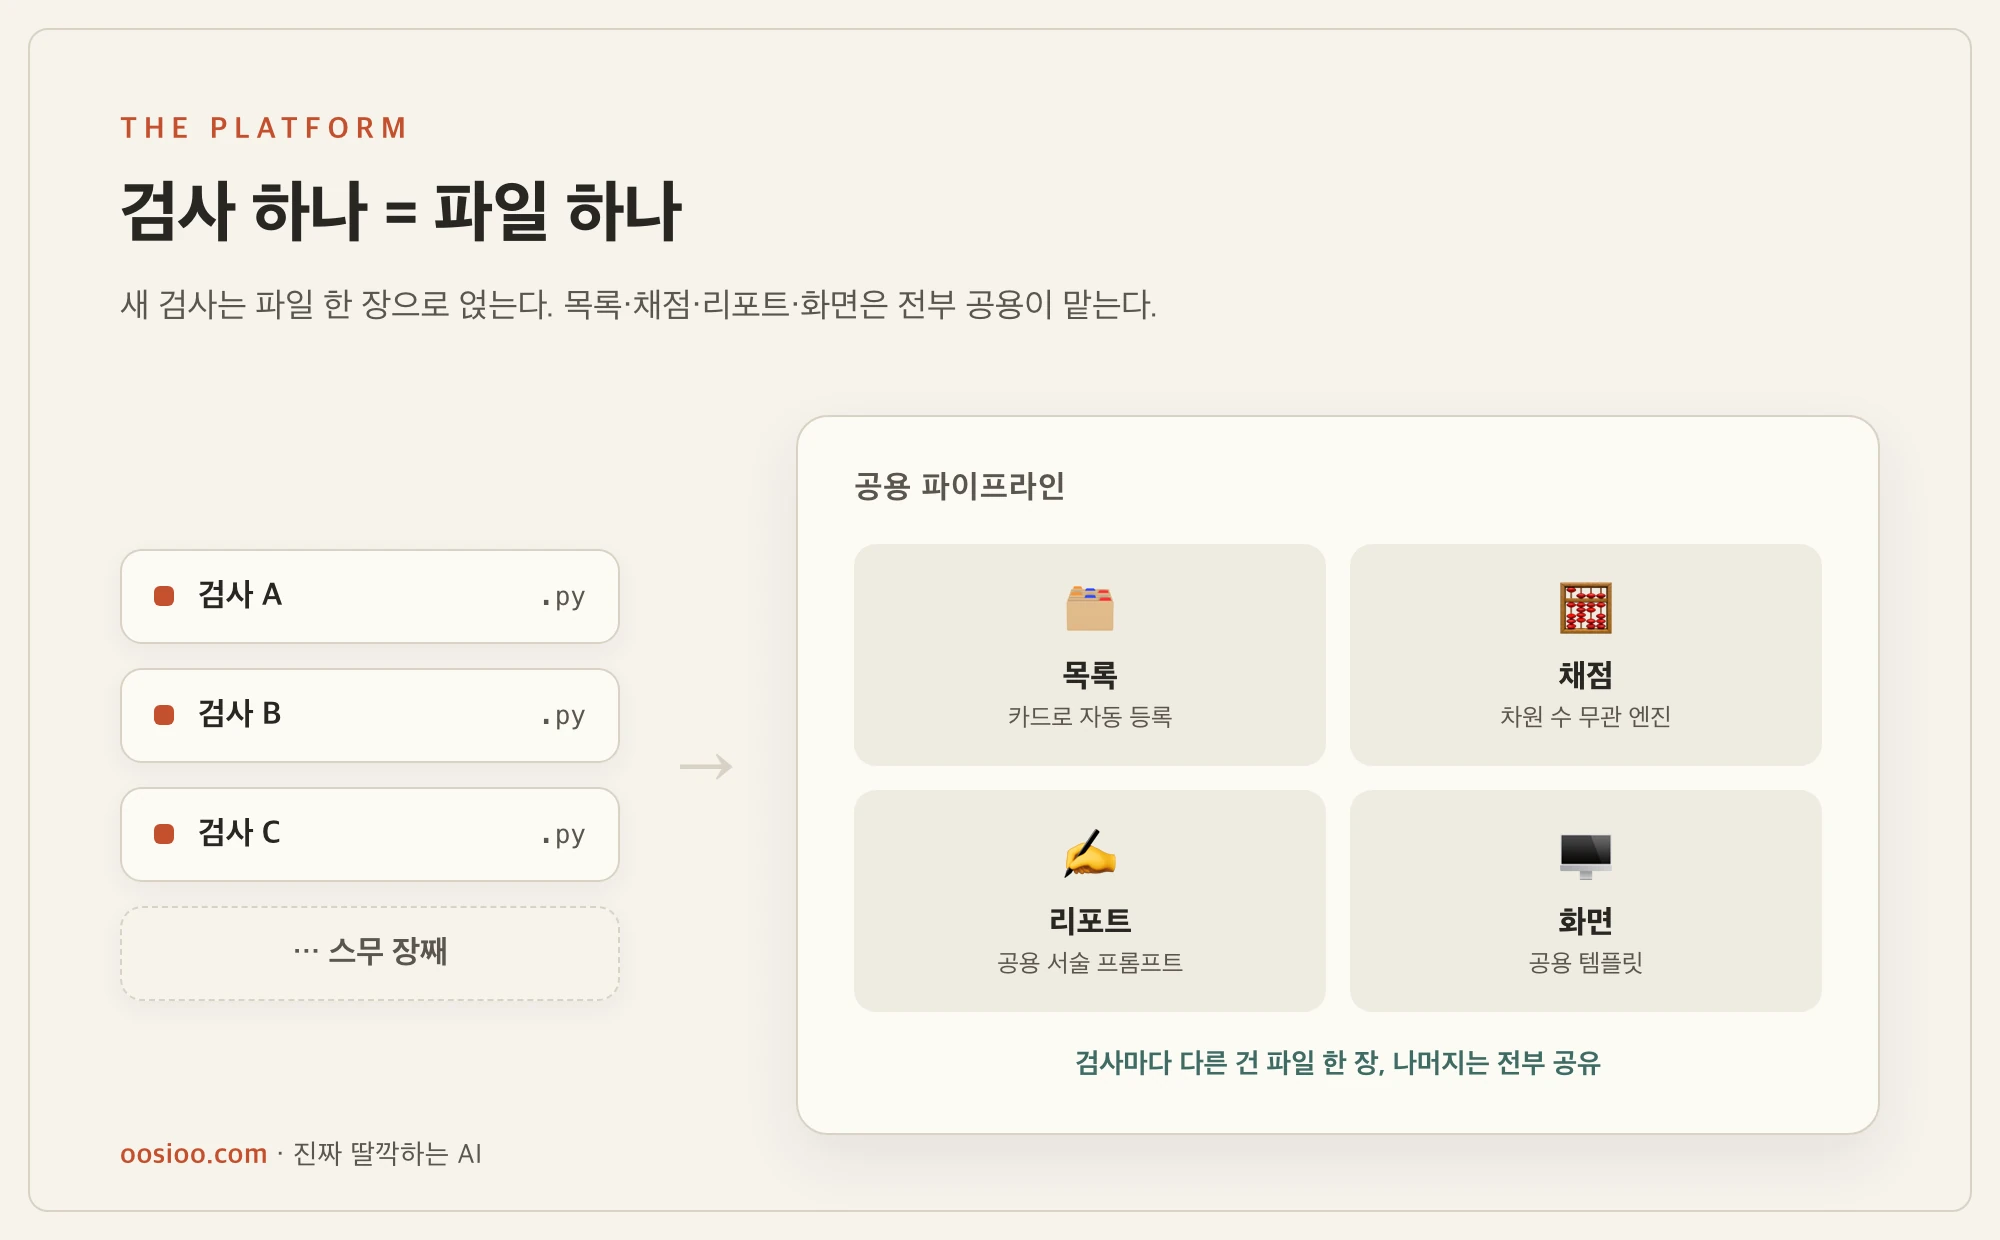
그래서 방향을 틀었다. 검사 한 종을 파일 하나로 만들 수 있게 구조를 바꿨다.
검사가 계속 늘어날 것 같다. 검사마다 코드를 복사하지 말고, 검사 하나를 파일 하나에 정의하면 목록·채점·리포트·화면이 알아서 붙는 구조로 리팩터링해달라. 새 검사를 추가할 때 내가 건드릴 파일이 딱 하나였으면 좋겠다.
지금은 비슷한 간이 검사가 스무 개쯤 된다. 성격, 흥미, 관계, 일하는 성향, 공부 방식에 재미로 만든 것들까지, 몇 갈래 카테고리로 나뉘어 있다.
파일 하나로 검사 하나
새 검사를 더하는 절차는 이렇게 줄었다.
- 폴더에 파일을 하나 만든다. 그 안에 검사 이름, 측정할 차원들, 문항, 리포트 설정을 적는다.
- 목록에 그 파일을 한 줄 등록한다.
- 끝이다.
채점은 차원이 몇 개든 상관없이 도는 공용 엔진이 맡고, 리포트 문장은 공용 프롬프트가 만들고, 화면도 공용 템플릿이 그린다. 검사마다 다른 건 파일 하나에 다 들어 있고, 나머지는 전부 공유한다. 문항 수백 개를 새로 쓸 때는 AI 여러 개를 동시에 돌려 차원별로 나눠 쓰게 하고 마지막에 합쳐서 검증했다.
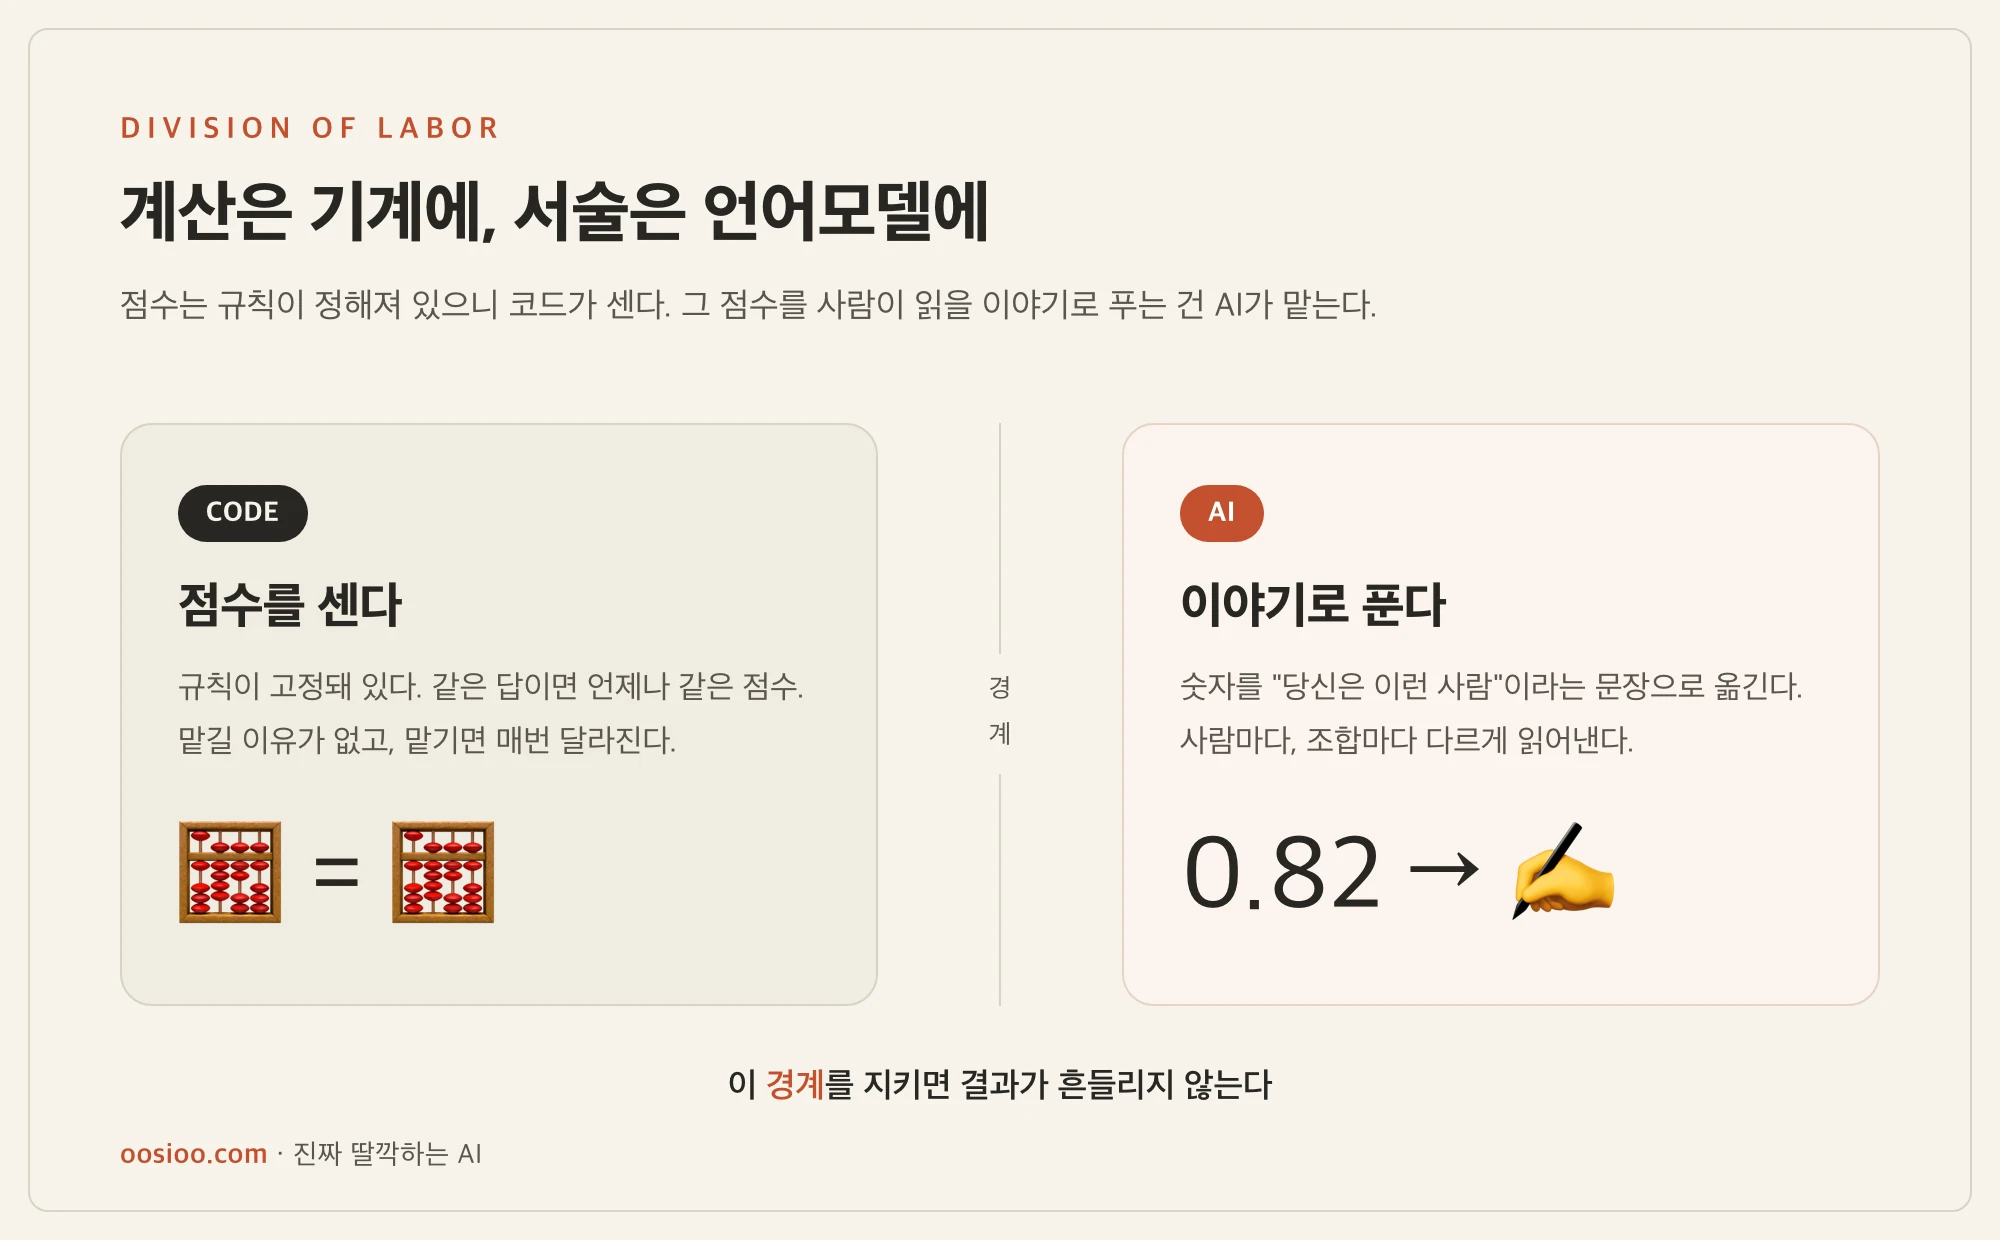
여기서 일을 둘로 나눈 게 핵심이다. 점수는 코드가 계산한다. 규칙이 정해져 있으니 AI에 맡길 이유가 없고, 맡기면 오히려 매번 답이 달라진다. 대신 그 점수를 사람이 읽을 이야기로 풀어내는 건 AI가 한다. 계산은 기계에, 서술은 언어모델에. 이 경계를 지키면 결과가 흔들리지 않는다.
실제 사용자가 구조를 한 번 더 바꿨다
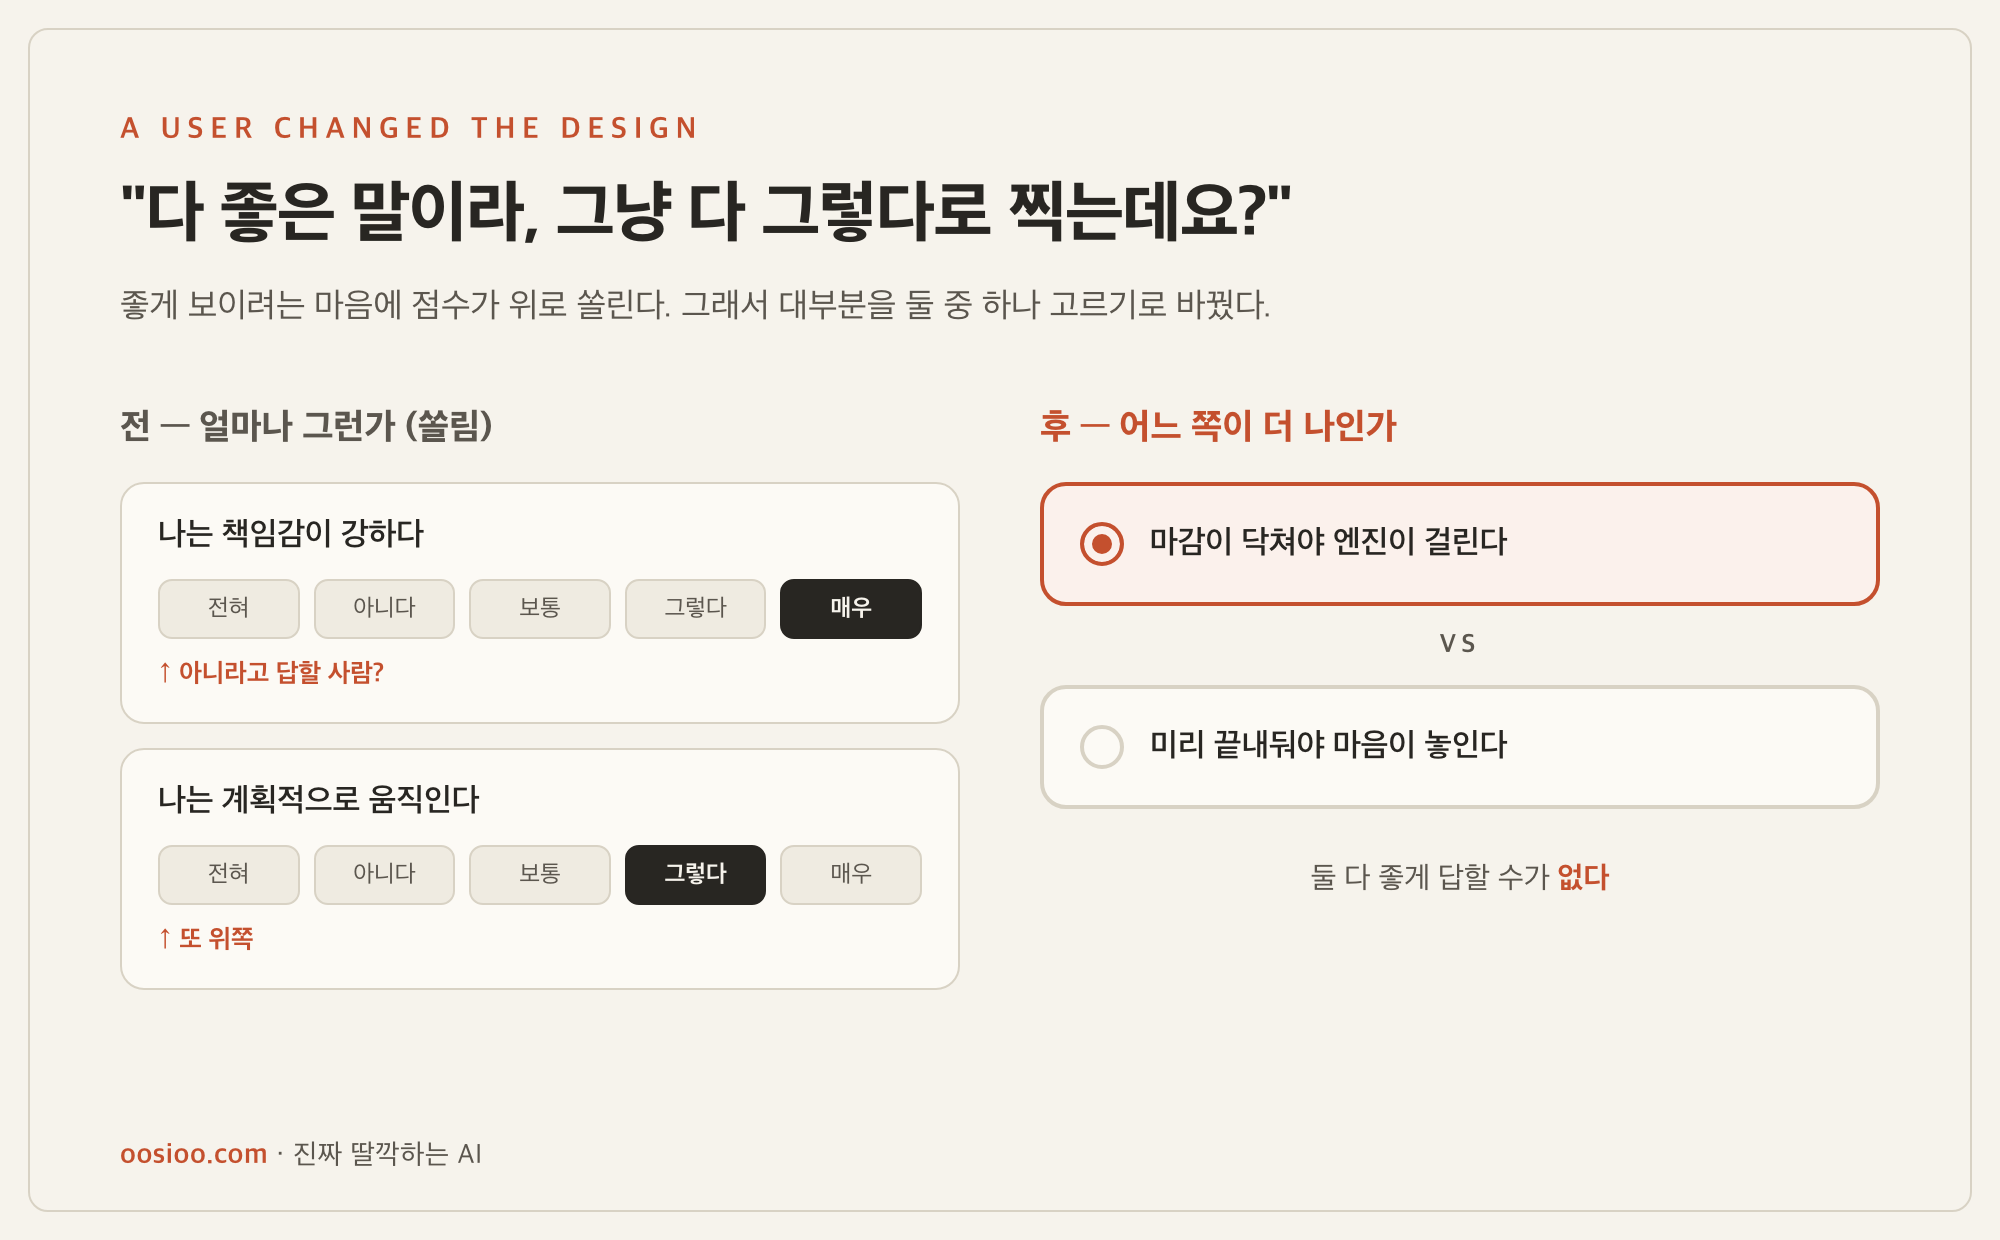
지인에게 써보라고 줬더니 이런 말을 했다. "문항이 다 대놓고 좋은 말이라, 그냥 다 '그렇다'로 찍게 되는데요?"
맞는 지적이었다. "나는 책임감이 강하다" 같은 문항에 아니라고 답할 사람은 별로 없다. 다들 자기를 좋게 그리려 하니까 점수가 위로 쏠린다.
그래서 다시 갈아엎었다. 대부분의 검사를 둘 중 하나 고르기로 바꿨다. 서로 다른 두 성향을 나란히 놓고 어느 쪽이 더 나에 가까운지 고르게 하면, 둘 다 좋게 답할 수가 없다. 다만 지친 정도나 회복력처럼 얼마나 심한가 그 절대 수준이 중요한 검사 몇 개는 원래의 척도형으로 남겼다. 이것도 검사가 파일 하나로 떨어져 있으니, 포맷을 바꾸는 것도 그 파일만 손대면 됐다.
그런데 이런 거, 세상엔 이미 많더라
만들고 나서 궁금해서 둘러봤다. 비슷한 걸 하는 데가 아주 많았다.
가장 유명한 축은 성격을 네 글자로 찍어주는 부류다. 네 글자 유형이라고만 해도 다들 뭔지 짐작이 갈 것이다. 제일 널리 쓰이는 온라인판은 한 영국 회사가 운영하는데, 자기들 집계로만 10억 번 넘게 치러졌다고 한다. 재밌는 건 이게 그 유명한 네 글자 검사의 형식만 빌렸을 뿐, 속은 학계에서 더 인정받는 다른 모델(흔히 '5요인'이라 부르는 Big Five)에 기대고 있다는 점이다.
정작 원조인 그 네 글자 검사는 평이 복잡하다. 20세기 초 융의 이론을 바탕으로 한 모녀가 만들었는데, 두 사람 다 심리학 전공자가 아니었다. 학계에선 오래전부터 깐깐한 비판이 붙어 있다. 같은 사람이 몇 주 뒤에 다시 풀면 유형이 바뀌는 일이 흔하고, 미국 국립과학원도 1991년에 "이걸 진로 상담에 쓸 근거가 충분치 않다"고 선을 그었다. 학자들이 더 신뢰하는 5요인 모델은 아예 문항을 공개해둬서, 수천 개짜리 공개 문항 풀을 누구나 가져다 연구에 쓴다.
요즘은 AI로 사람을 평가하는 쪽도 부쩍 늘었다. 어떤 회사는 지원자의 영상 면접을 AI로 분석해 채용에 썼다. 한동안 표정까지 읽었는데, 결국 그 표정 분석은 접었다. 값어치가 없고 논란만 컸다는 이유였다. 공개된 SNS 데이터만으로 상대의 성격을 추론해준다는 서비스도 있다. 그런데 2022년에 외부 연구진이 뜯어봤더니, 똑같은 이력서를 PDF로 넣느냐 텍스트로 넣느냐에 따라 성격 점수가 달라졌다. 연구진은 "유효한 검사 도구로 볼 수 없다"고 결론 냈다. 이런 일들이 쌓이자 뉴욕시와 EU는 채용에 쓰는 AI를 따로 묶어 편향 감사를 의무로 걸기 시작했다.
반대편엔 결이 전혀 다른 세계가 있다. 진짜 검사를 만드는 곳들이다. 국내만 봐도 유명한 해외 검사의 한국판을 들여와 표준화한 곳, 심리검사를 260종 넘게 내는 곳이 있다. 이런 검사 하나가 나오려면 수천 명을 대상으로 기준선(규준)을 잡고, 같은 사람이 다시 풀어도 비슷하게 나오는지, 재려던 걸 제대로 재는지를 통계로 검증한다. 문항 몇백 개는 교수와 임상의 수십·수백 명이 붙어서 쓴다. 내가 주말에 AI랑 지어낸 문항과는 출발선이 다르다.
동시에, 그 네 글자 검사가 한국에서 크게 유행하면서 엉뚱한 데 쓰이는 일도 생겼다. 특정 유형은 지원하지 말라는 채용 공고까지 나왔다. 전문가들은 한목소리로 말린다. 채용에서 이걸로 성격을 판단하는 건 위험하다고. 재미로 보라고 만든 도구에 사람의 당락을 얹는 순간, 그건 다른 문제가 된다.
그래서, 왜 이게 딸깍인가
사람들은 딸깍을 하나를 뚝딱 만드는 것으로 생각한다. 그런데 진짜 힘이 세지는 지점은 따로 있다. 스물한 번째를 공짜로 만들 수 있게 판을 짜두는 것이다. AI는 같은 꼴의 것을 하나 더 만드는 데 유난히 강하다. 그러니 처음에 검사 하나가 아니라 검사를 담는 틀을 만들어두면, 그다음부터는 검사가 떠오를 때마다 파일 하나만 얹으면 된다. 하나를 만드는 힘으로 스무 개짜리 판을 갖게 된 셈이다.
그런데 둘러보고 나니 한 가지가 더 또렷해졌다. 검사처럼 보이는 걸 만드는 일과, 진짜 검사를 만드는 일은 전혀 다른 난이도라는 것이다.
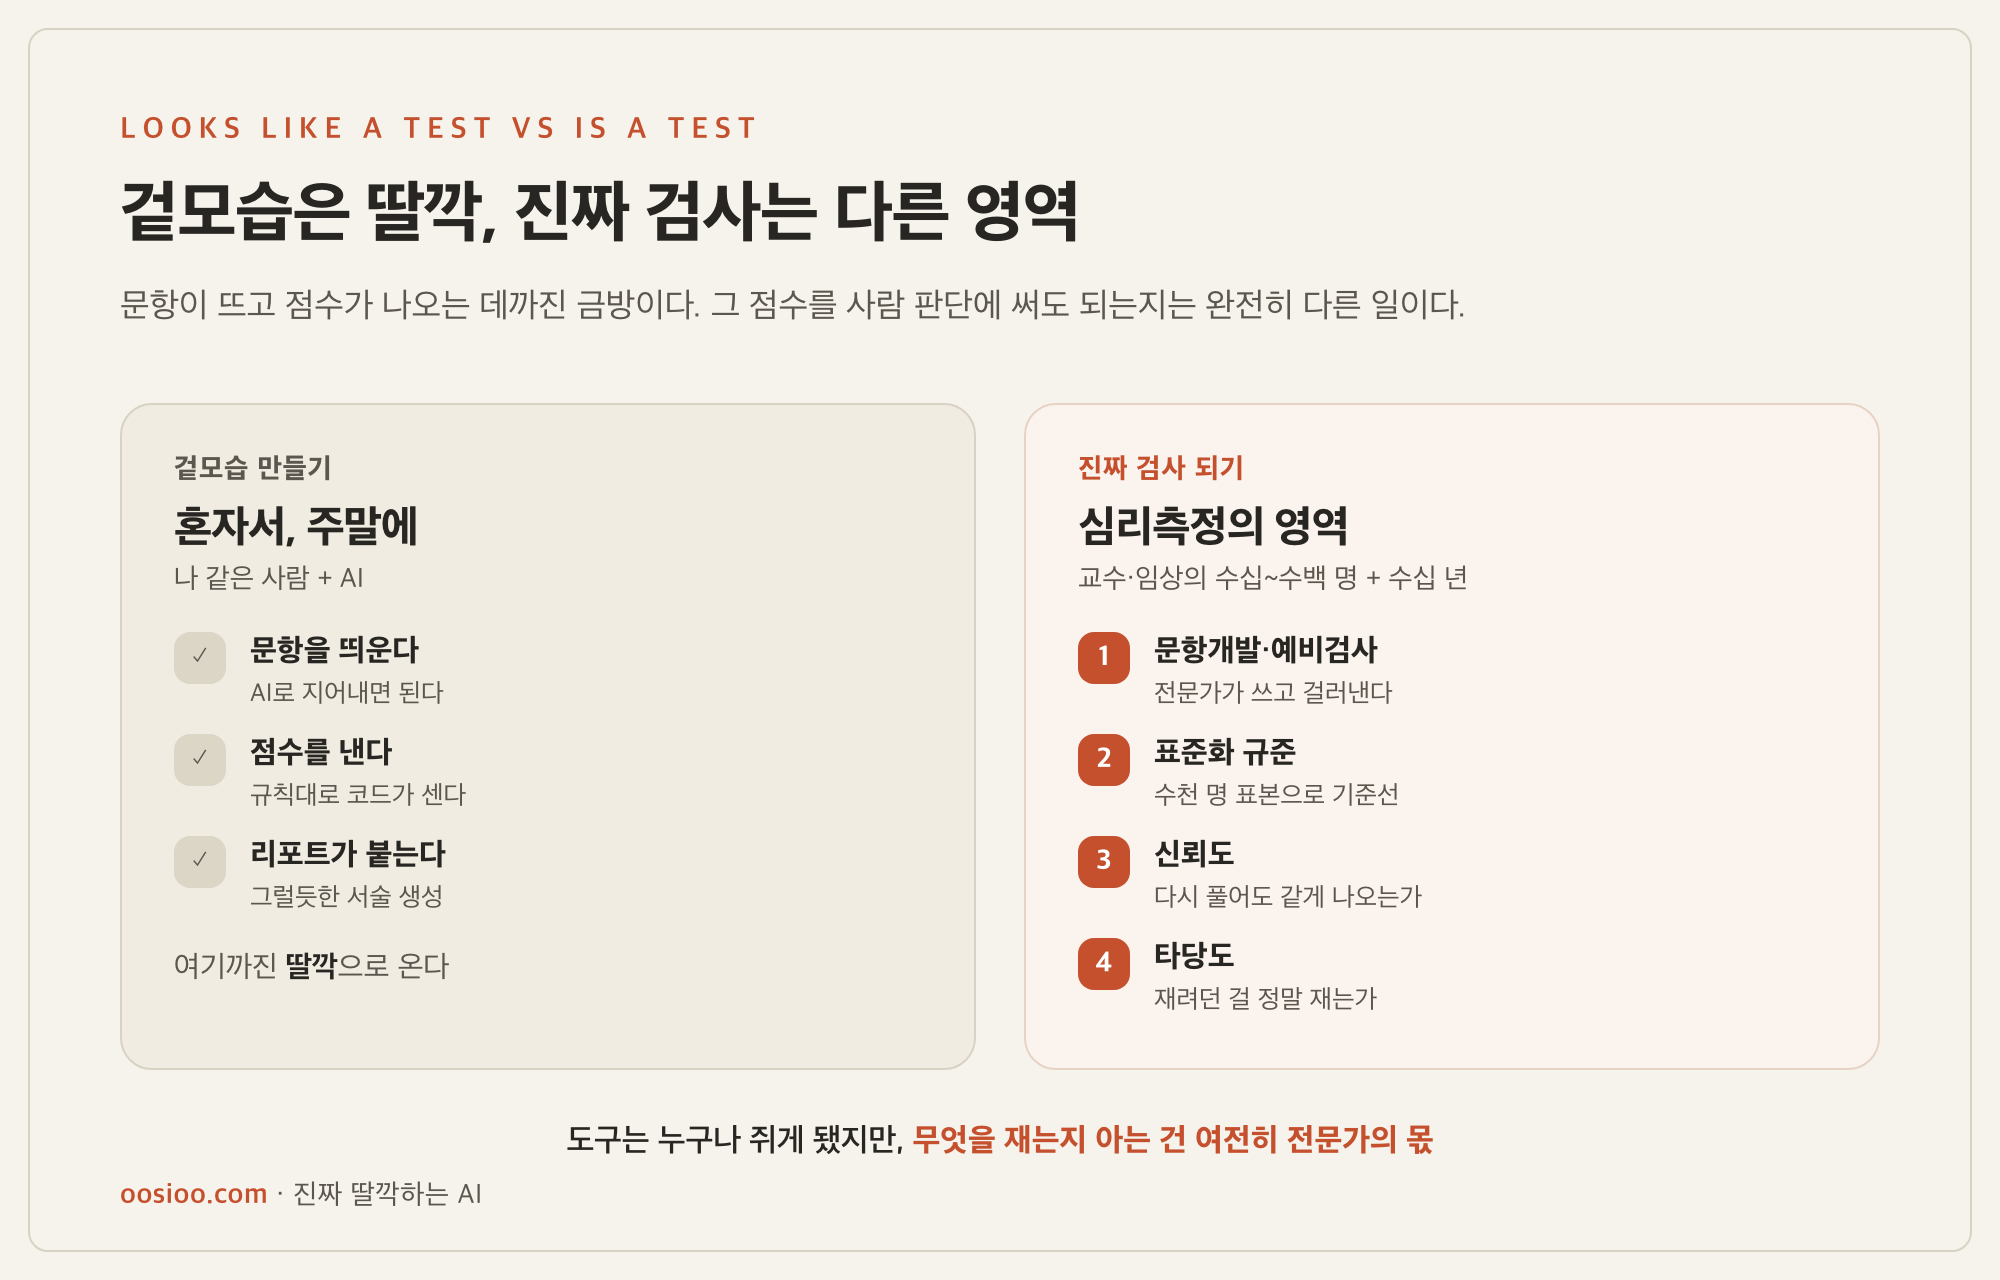
틀을 짜두면 겉모습은 얼마든지 찍어낼 수 있다. 문항이 뜨고, 점수가 나오고, 그럴듯한 리포트가 붙는다. 딸깍으로 여기까진 금방 온다. 하지만 그 점수가 정말 무언가를 재고 있는지, 다음에 풀어도 같게 나오는지, 그래서 사람에 대한 판단에 써도 되는지는 완전히 다른 영역이다. 그건 코드가 아니라 심리측정이라는 분야가 수십 년 쌓아온 지식이다. 수천 명 규준, 신뢰도와 타당도 검증, 문항을 쓰고 고르는 안목. 이건 AI한테 "검사 하나 만들어줘" 한다고 나오는 게 아니다.
그래서 나는 내가 만든 걸 처음부터 재미용이라고 못 박아뒀다. 자기를 들여다보는 가벼운 거울이지, 진단이 아니다. 딸깍이 열어주는 건 넓다. 혼자서도 꽤 그럴듯한 걸 빠르게 세울 수 있다. 다만 그 위에 사람의 무게가 실리는 일, 그러니까 채용이나 진단, 선발 같은 데로 넘어가는 순간부터는 반드시 그 분야를 아는 사람의 손이 필요하다. 도구는 누구나 쥘 수 있게 됐지만, 무엇을 재고 있는지 아는 건 여전히 전문가의 몫이다.
정직하게 덧붙이면, 만들고 나서의 유지보수도 또 별개의 일이다. 사용자가 몰리면 리포트를 만드는 AI 호출이 줄줄이 밀리기도 하고, 그걸 순서대로 처리하는 장치를 따로 붙여야 했다. 딸깍으로 태어난 것도 살아 있는 동안엔 손이 간다.